실시간 전사 여섯 가지를 같은 녹음으로 측정해 봤습니다 - Deepgram, Cartesia, Whisper, Qwen3-ASR
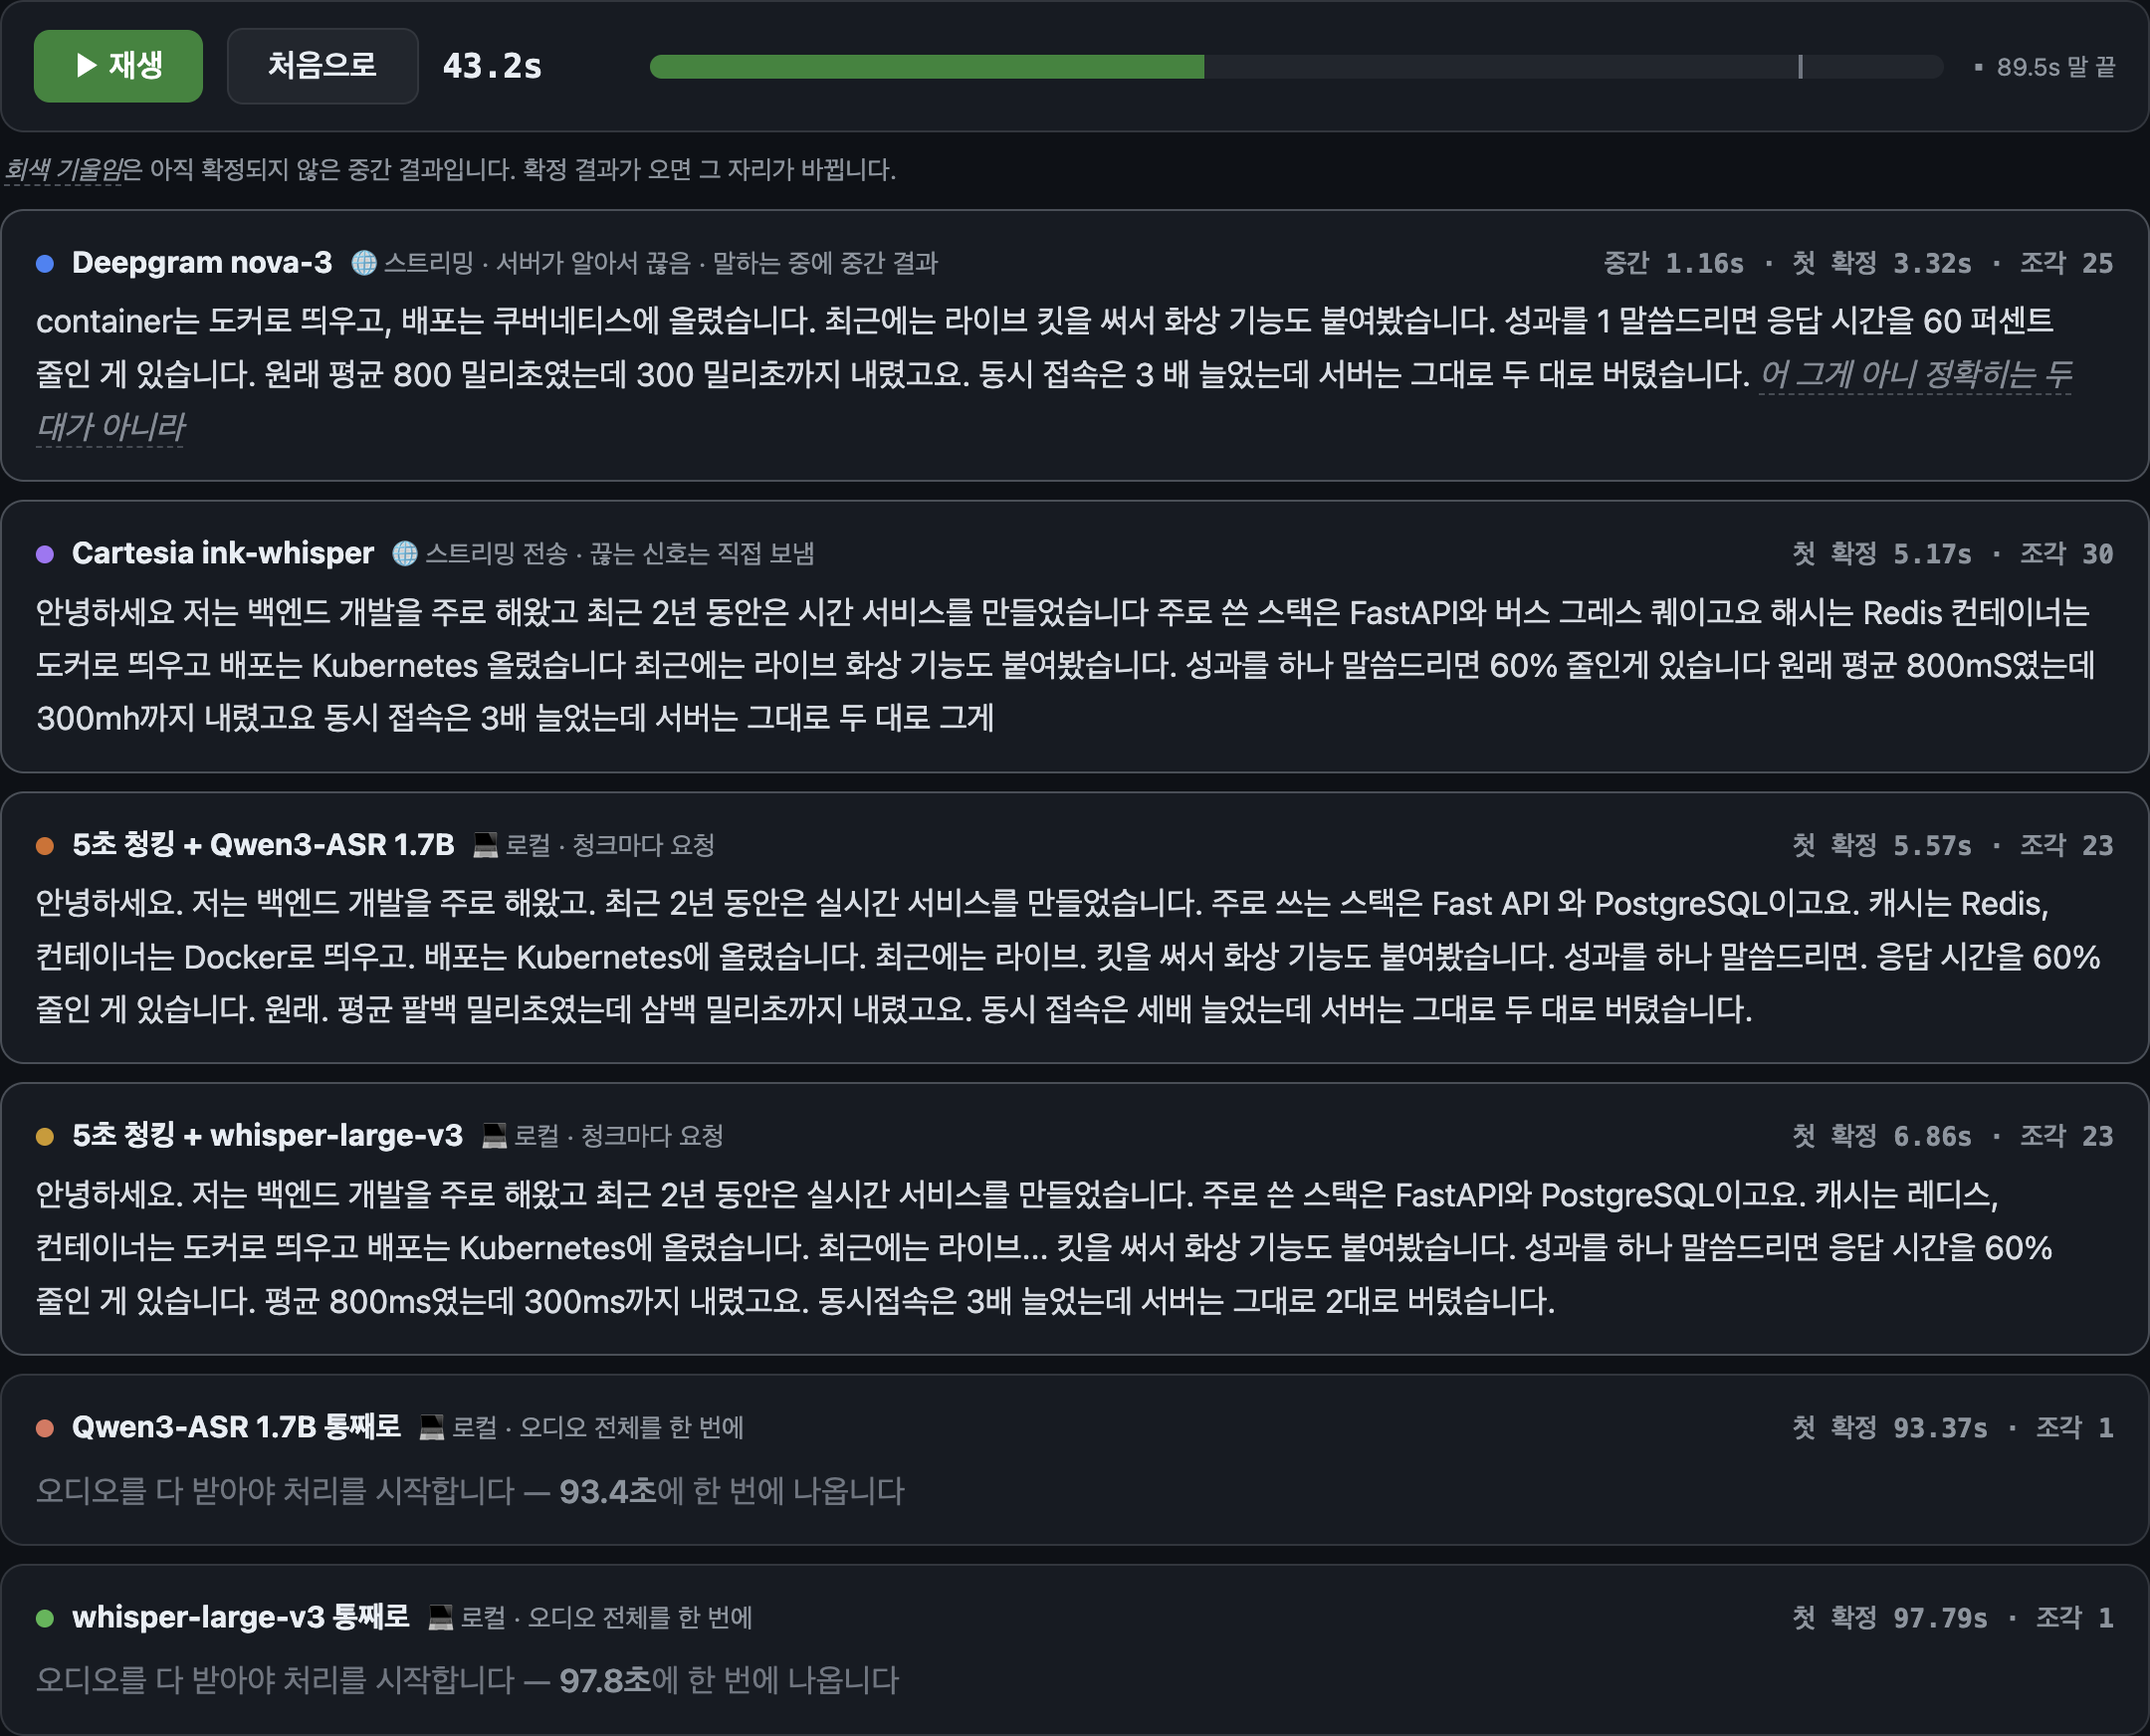
“스트리밍이 빠르다”는 말은 많이 들었지만, 화면에서 실제로 어떻게 보이는지는 본 적이 없었습니다. 그래서 89초짜리 한국어 면접 답변을 녹음해 여섯 가지 방식에 똑같이 흘려보내고, 각 방식이 언제 무엇을 내놓는지 기록했습니다.
요약하면 이렇습니다. 글자를 가장 빨리 띄운 스트리밍 두 곳은 PostgreSQL을 잘못 받아 적었습니다. 오디오를 길게 넣을수록 고유명사를 더 잘 맞혔지만, 결과는 그만큼 늦게 나왔습니다.
아래 화면은 측정한 시각 그대로 재생됩니다.
진행 막대를 누르면 원하는 지점으로 옮길 수 있습니다. 음성은 89.5초에 끝나지만 막대는 100초까지 이어집니다. 통째로 처리하는 두 방식의 결과가 그 뒤에 나오기 때문입니다. 여섯 방식의 전사 전문은 전체 화면에 모아 두었습니다.
읽은 대본 - 89초, 면접 답변 상황
안녕하세요. 저는 백엔드 개발을 주로 해 왔고, 최근 이 년 동안은 실시간 서비스를 만들었습니다.
주로 쓴 스택은 FastAPI와 PostgreSQL이고요, 캐시는 Redis, 컨테이너는 Docker로 띄우고 배포는 쿠버네티스에 올렸습니다. 최근에는 LiveKit을 써서 화상 기능도 붙여 봤습니다.
[2초 쉼]
음… 성과를 하나 말씀드리면, 응답 시간을 육십 퍼센트 줄인 게 있습니다. 원래 평균 팔백 밀리초였는데 삼백 밀리초까지 내렸고요. 동시 접속은 세 배 늘었는데 서버는 그대로 두 대로 버텼습니다.
어, 그게… 아니 정확히는 두 대가 아니라 세 대였네요. 오토스케일링이 한 대를 더 띄우고 있었습니다.
[2초 쉼]
가장 어려웠던 건 웹소켓 연결이 자꾸 끊기는 문제였습니다. 로그를 봐도 원인이 안 나와서, 프록시 설정을 하나씩 걷어내 봤는데 결국 Nginx의 타임아웃이 육십 초로 잡혀 있던 게 원인이었어요. 그걸 찾는 데 이틀이 걸렸습니다.
[여기부터 조금 빠르게] 그 뒤로는 하트비트를 삼십 초마다 보내도록 바꿨고, 재연결 로직에 지수 백오프를 넣어서 서버가 몰리지 않게 했습니다. 지금은 끊김이 거의 없습니다.
[2초 쉼]
아, 그리고 팀에서 STT를 붙일 때 청크를 오 초씩 잘라서 보냈는데, 그러다 보니 숫자가 깨지는 경우가 있었습니다. 그래서 무음 구간을 찾아서 자르는 방식으로 바꿨습니다.
이상입니다. 감사합니다.
대본에는 틀리기 쉬운 요소를 일부러 넣었습니다. 고유명사 일곱 개, 숫자와 단위, 앞에서 한 말을 뒤에서 정정하는 대목, 추임새, 2초 쉼 세 곳, 빠르게 읽는 구간입니다. 숫자는 읽을 때 헷갈리지 않도록 한글로 적었습니다.
결론부터
| 방식 | 중간 결과 | 첫 확정 | PostgreSQL | LiveKit | 무음 |
|---|---|---|---|---|---|
| Deepgram nova-3 | 1.16s | 3.32s | ❌ | ❌ | ❌ |
| Cartesia ink-whisper | 없음 | 5.17s | ❌ | ❌ | ❌ |
| 5초 청킹 + Qwen3-ASR 1.7B | 없음 | 5.57s | ✅ | ❌ | ❌ |
| 5초 청킹 + whisper-large-v3 | 없음 | 6.86s | ✅ | ❌ | ❌ |
| Qwen3-ASR 1.7B 통째로 | 없음 | 93.37s | ✅ | ✅ | ❌ |
| whisper-large-v3 통째로 | 없음 | 97.79s | ✅ | ❌ | ✅ |
오른쪽 세 칸은 해당 단어를 철자까지 맞게 적었는지를 나타낸다. 시각은 오디오 시작을 0초로 잡았다
- 글자를 가장 먼저 띄운 건 Deepgram입니다. 1.16초에 “안녕하세요.”가 떴습니다. 다만 이건 아직 바뀔 수 있는 중간 결과이고, 확정 결과는 3.32초에 나왔습니다.
- 스트리밍 두 곳은 모두 PostgreSQL을 잘못 적었습니다. 조각으로든 통째로든 오디오를 모아서 모델에 넣은 나머지 넷은 모두 맞게 적었습니다.
- 통째로 넣은 쪽이 가장 많이 맞혔지만 가장 늦습니다. 처리 자체는 4~8초면 끝나는데, 말이 다 끝나야 처리를 시작할 수 있어서 첫 글자가 90초가 넘어서야 나옵니다.
- “무음”은 여섯 중 다섯이 “모음”으로 적었습니다. 문맥을 넓게 본다고 풀리는 문제도 아니었습니다. 녹음 전체를 넣은 Qwen도 틀렸습니다.
측정 방법
같은 녹음을 16kHz 모노로 변환해 여섯 방식에 넣었습니다.
스트리밍 둘에는 오디오를 100ms 분량씩 보내고 100ms 쉬는 식으로, 말하는 속도 그대로 흘려보냈습니다. 파일을 한꺼번에 밀어 넣으면 지연이 거의 0으로 나오지만, 사람이 말하는 상황과는 거리가 멉니다.
1
2
3
for i in range(0, len(pcm), step):          # step = 100ms 분량
    await ws.send(pcm[i:i + step])
    await asyncio.sleep(0.1)                # 말하는 속도에 맞춘다
5초 청킹 둘은 배치 STT로 실시간 자막을 흉내 낼 때 흔히 쓰는 방식입니다. 오디오를 쌓다가 700ms 무음이 나오면 자르고, 5초를 넘기면 마지막 1.5초 안에서 가장 조용한 지점을 찾아 자릅니다. 89초가 23조각으로 나뉘었는데, 무음에서 잘린 게 10개, 5초 상한에 걸려 강제로 잘린 게 13개였습니다. 잘린 조각은 동시에 3개까지 모델에 보냈습니다.
통째로 둘은 89.45초를 다 받은 뒤 한 번에 넣었습니다. 그래서 첫 글자 시각은 89.45초에 처리 시간을 더한 값입니다. 처리에는 Qwen이 3.9초, whisper가 8.3초 걸렸습니다. 오디오 길이보다 각각 22.8배, 10.7배 빠른 셈입니다.
로컬 넷은 M5 Max 맥북에서 실행했습니다. whisper는 mlx-whisper로 whisper-large-v3-mlx를, Qwen은 mlx-audio로 Qwen3-ASR-1.7B-4bit를 돌렸습니다.
스트리밍 둘은 “어디서 끊을지”를 누가 정하느냐가 다릅니다
둘 다 웹소켓으로 오디오를 흘려보낸다는 점은 같습니다. 차이는 문장이 어디서 끝나는지를 누가 판단하느냐입니다.
Deepgram은 서버가 정합니다
wss://api.deepgram.com/v1/listen에 오디오만 보내면 서버가 말이 끊긴 지점을 알아서 찾아 문장을 확정합니다. 끊는 기준(endpointing)은 기본값 그대로 두었습니다. 여기에 interim_results=true를 켜면 확정 전이라도 지금까지 들은 만큼의 추측을 계속 보내 줍니다. 이번 측정에서 텍스트가 들어 있는 확정 결과가 25개, 중간 결과가 66개 왔습니다. 그 밖에 punctuate=true와 smart_format=true를 켰습니다.
말이 끝난 뒤 확정 결과가 오기까지는 중앙값으로 1.23초가 걸렸습니다. 그 1초 남짓을 중간 결과가 메웁니다. 위 화면에서 회색 기울임 글자로 보이는 부분입니다.
Cartesia는 제가 정해야 했습니다
Cartesia에도 서버가 알아서 끊어 주는 엔드포인트(/stt/turns/websocket)가 있습니다. 그런데 한국어를 쓰려고 ink-whisper로 연결하면 연결이 바로 끊깁니다.
1
2
websockets.exceptions.ConnectionClosedError:
  received 1008 (policy violation) Unsupported model
현재 Cartesia의 주력 모델은 ink-2(영어)와 ink-preview(영어, 프랑스어, 힌디어, 일본어, 스페인어)이고, 한국어를 지원하는 ink-whisper는 이전 모델 목록에 있습니다. 요금표에는 ink-whisper의 turns 단가도 적혀 있지만, 2026-09-23에 cartesia_version=2025-04-16으로 연결했을 때는 위처럼 거절됐습니다.
그래서 수동 엔드포인트(/stt/websocket)를 썼습니다. 여기서는 오디오를 아무리 보내도 결과가 오지 않습니다. 클라이언트가 finalize를 보내야 서버가 “여기까지가 한 문장”으로 보고 결과를 돌려줍니다.
1
2
3
while cuts and sent_ms >= cuts[0]:   # 끊을 시각이 되면
    await ws.send("finalize")        # 여기까지 확정해 달라고 알린다
    cuts.pop(0)
오디오를 실시간으로 흘려보내니 전송 방식은 스트리밍이 맞습니다. 하지만 어디서 끊을지는 클라이언트가 판단해야 합니다. 비교 조건을 맞추려고 5초 청킹이 자른 시각과 같은 시각에 finalize를 보냈습니다.
첫 결과가 5.17초에 나온 것도 이 때문입니다. 첫 조각이 5초 상한에 걸려 잘렸고, 그 시각에 보낸 첫 finalize에 0.17초 만에 응답이 왔습니다. 이번 측정에서 받은 결과 37개는 전부 확정 결과였고, 그중 7개는 빈 문자열이었습니다.
중간 결과는 틀렸다가 고쳐집니다
Deepgram의 중간 결과는 말이 이어질수록 계속 바뀝니다. 첫 문장은 이렇게 바뀌어 갔습니다.
1
2
3
4
1.16s  중간  안녕하세요.
2.15s  중간  안녕하세요. 저는 맥엔드
3.12s  중간  안녕하세요. 저는 백엔드 개발을 주로 해야
3.32s  확정  안녕하세요. 저는 백엔드 개발을 주로 해학
“맥엔드”는 뒷말이 들어오면서 “백엔드”로 고쳐졌습니다. “쿠번에”가 “쿠버네티스에”로, “두 배”가 “두 대로”로 바뀐 곳도 있었습니다.
반대로 확정 결과가 중간 결과보다 나빠진 곳도 있습니다. 실제 발화는 “해 왔고”였는데, 중간 결과의 “해야”가 확정 결과에서 “해학”이 됐습니다. 51초 무렵에는 중간 결과에 “웹 소켓 연결이 자꾸”까지 나와 있었는데, 확정 결과가 “가장 어려웠던 건 웹”과 “연결이 자꾸 끊기는 문제였습니다” 둘로 나뉘면서 “소켓”이 빠졌습니다. 중간 결과를 화면에 띄우면 빨리 보여 줄 수 있지만, 그만큼 사용자는 글자가 바뀌는 과정을 보게 됩니다.
문맥이 짧으면 어디서 틀리나
PostgreSQL
1
2
3
원문        주로 쓴 스택은 FastAPI와 PostgreSQL이고요
Deepgram    주로 쓴 스택은 fast API와 first Gras Ql이고요.
Cartesia    주로 쓴 스택은 FastAPI와 버스 그레스 퀘이고요
나머지 넷은 모두 PostgreSQL로 적었습니다. 같은 지점에서 끊은 Cartesia와 5초 청킹 + whisper의 결과가 갈렸으니, 끊는 위치만으로는 설명이 되지 않습니다. 모델 차이도 영향을 준 것으로 보입니다.
숫자와 단위
대본의 “팔백 밀리초”, “삼백 밀리초”는 한글 그대로 소리 내어 읽었습니다.
1
2
3
Deepgram          800 밀리초였는데 300 밀리초까지 내렸고요
Cartesia          800mS였는데 300mh까지 내렸고요
청킹 + whisper    800ms였는데 300ms까지 내렸고요
Cartesia는 300ms를 300mh로 적었습니다. 숫자는 맞고 단위만 틀려서, 읽는 사람이 틀린 줄 모르고 지나치기 쉬운 오류입니다.
말을 정정하는 대목
원문은 “두 대로 버텼습니다. 어, 그게… 아니 정확히는 두 대가 아니라 세 대였네요.”입니다. Deepgram만 뒷부분을 “세 개였네요”로 적었고, 나머지 다섯은 “세 대”로 맞게 적었습니다.
무음과 모음
“무음 구간을 찾아서 자르는 방식으로”는 whisper 통째로만 맞게 적었고, 나머지 다섯은 모두 “모음 구간”으로 적었습니다. 발음이 거의 같아서 문맥으로만 구별할 수 있는 단어입니다. 오디오를 끝까지 다 들은 Qwen도 틀렸으니, 문맥을 늘리는 것만으로는 해결되지 않는 부분입니다.
LiveKit
철자까지 맞게 적은 건 Qwen 통째로(LiveKit을) 하나뿐이었습니다. 나머지는 “라이브 킷”, “라이브킷”, “라이브. 킷”, “라이브… 킷”이었고, Cartesia는 “킷”을 아예 빠뜨렸습니다.
눈여겨볼 점은 같은 Qwen도 5초씩 잘라 넣으면 틀렸다는 것입니다. 한 번에 들려준 오디오의 길이가 결과를 갈랐습니다.
그래서 무엇을 고를까
우열을 가리려는 실험은 아니었습니다. 다만 무엇을 얻고 무엇을 포기하게 되는지는 분명하게 드러났습니다.
- 말하는 동안 자막이 떠야 한다면 중간 결과를 주는 스트리밍이 맞습니다. 대신 글자가 바뀌는 게 그대로 보이고, 고유명사는 틀릴 각오를 해야 합니다.
- 고유명사와 숫자가 중요하다면 후보 모델을 직접 비교해 봐야 합니다. 같은 지점에서 잘라도 모델에 따라 PostgreSQL 결과가 갈렸고, LiveKit은 통째로 넣은 Qwen 하나만 맞혔습니다.
- 둘 다 필요하다면 두 방식을 함께 쓸 수 있습니다. 말하는 동안에는 스트리밍 결과를 보여 주고, 말이 끝나면 녹음 전체를 한 번 더 처리해 확정본으로 바꾸는 방식입니다. 이번 녹음 기준으로 통째 처리는 4~8초면 끝났습니다.
읽을 때 감안할 점
- 표본이 하나입니다. 한 사람이 한 번 녹음한 89초로 서비스나 모델의 우열을 말할 수는 없습니다.
- 조건이 같지 않습니다. 스트리밍 둘은 네트워크를 거쳤고 나머지 넷은 제 맥북에서 실행했습니다. 5초 청킹은 보통 외부 API로 whisper를 호출하는데, 저는 같은 모델을 로컬에서 돌려서 네트워크 왕복 시간이 빠져 있습니다. 실제보다 빠르게 나온 값입니다. 같은 조건에서 모델만 바꾼 두 청킹 방식끼리는 비교해도 됩니다.
- 정확도는 눈으로 확인했습니다. 오류율(CER) 같은 수치는 측정하지 않았고, 대본에 일부러 넣은 단어를 맞게 적었는지만 확인했습니다.
비용
2026-09-23에 각 요금 페이지를 보고 적었습니다.
- Cartesia:
ink-whisper실시간은 오디오 1초에 1크레딧입니다. 무료 플랜이 매달 20,000크레딧을 주니 한 달에 5시간 33분을 쓸 수 있습니다. 말이 없는 구간도 연결돼 있는 시간만큼 크레딧이 차감됩니다. (요금 안내) - Deepgram: 가입하면 $200 크레딧을 줍니다. Nova-3 단일 언어 스트리밍은 현재 분당 $0.0048인데, 이는 기간 한정 할인가이고 정가는 $0.0077입니다. $200로 할인가 기준 약 694시간, 정가 기준 약 433시간을 쓸 수 있습니다. (요금 안내)
- 로컬: 모델만 내려받으면 비용이 들지 않습니다.