Gemini TTS 네 가지로 같은 팟캐스트를 만들어 봤습니다 - 3.8 Flash, 3.8 Flash-Lite, 3.1 Flash, 2.5 Pro
Gemini TTS 3.8 시험기 3편 중 1편입니다. 1편 네 모델 비교 · 2편 내 목소리 복제 · 3편 3.8 기능 시험
2인 대화 팟캐스트를 만드는 스킬을 쓰고 있습니다. 대본을 쓰면 Gemini 다화자 TTS가 진행자와 게스트 목소리로 읽어 주는 방식입니다. 기본 모델을 gemini-3.1-flash-tts-preview에서 새로 나온 gemini-3.8-flash-tts로 올리면서, 같은 대본을 네 모델로 만들어 비교했습니다.
요약하면 이렇습니다. 3.8은 올해 말까지 3.1의 절반 이하 가격이고, 짧은 샘플의 품질은 구별되지 않았습니다. 다만 모델 이름만 바꾸면 요청이 전부 실패하고, 영어로 적은 고유명사를 엉뚱한 단어로 읽는 경우가 있었습니다. 청크 사이 목소리 흔들림은 진행자 쪽만 나아졌습니다. 내 목소리 복제는 2편, 문서가 내세운 나머지 기능은 3편에 따로 정리했습니다.
결론부터
| 3.8 Flash | 3.8 Flash-Lite | 3.1 Flash | 2.5 Pro | |
|---|---|---|---|---|
| 상태 | 현재 | 현재 | 이전 | 이전 |
| 출력 단가(1M 토큰) | $9 (2027년 $18) | $6 (2027년 $12) | $20 | $20 |
| 품질(10점) | 8/9/10/8~9 | 7~8/9/10/8 | 8/9/10/8 | - |
| PostgreSQL 오독 | 2/3 | 0/3 | 0/2 | - |
| 청크 간 편차 | 8% / 16% | 6% / 13% | 12% / 15% | 6% / 7% |
| 목소리 복제(2편) | 만들기·읽기 | 읽기만 | 읽기만(문서상 미지원) | 안 됨 |
모델 ID는 gemini-3.8-flash-tts, gemini-3.8-flash-lite-tts, gemini-3.1-flash-tts-preview, gemini-2.5-pro-preview-tts다. 품질은 자연스러움/발음 명료도/화자 구분/대화 호흡, PostgreSQL 오독은 다른 단어로 읽은 횟수, 청크 간 편차는 진행자/게스트의 음 높이가 청크끼리 벌어진 정도(3회 평균)다
- 가격이 가장 크게 달라졌습니다. 3.8 Flash는 3.1보다 출력 단가가 55% 싸고, 2026년이 끝나 두 배로 올라도 조금 쌉니다.
- API가 호환되지 않게 바뀌었습니다. 모델 이름만 바꾸면 400 오류가 나고, 기본 출력이 WAV로 바뀌어 예전 코드로 이어 붙이면 청크마다 “딱” 소리가 납니다.
- 영어 고유명사는 한글로 적어야 합니다. 3.8 Flash가 “PostgreSQL은”을 「포스트지피티」 「포스트클라우드」로 읽었고, 대본에
포스트그레스큐엘로 적자 3회 모두 제대로 읽었습니다. - 목소리 일관성은 가장 오래된 2.5 Pro가 제일 좋았습니다. 3.8 Flash는 3.1보다 진행자가 안정됐지만 남성 게스트는 비슷하게 흔들렸습니다. 기본 목소리 Leda와 Charon은 미국 영어 목소리인데, 한국어 목소리로 바꾼 결과는 3편에 있습니다.
직접 들어 보세요
같은 대본(32줄, 1,387자)을 네 모델로 만들었습니다. 대본을 300자 안팎의 청크 네 개로 나눠 따로 만들고 0.25초 간격으로 이어 붙였습니다. 목소리는 모두 진행자 Leda, 게스트 Charon입니다.
골라서 싣지 않으려고 세 번 만든 것 중 모든 모델의 첫 번째 결과물을 그대로 올렸습니다. 3.1 Flash는 공교롭게 첫 번째가 세 번 중 청크 간 편차가 가장 컸던 회차입니다.
3.8 Flash (3분 10초)
3.8 Flash-Lite (2분 58초)
3.1 Flash (3분 9초)
2.5 Pro (2분 46초)
청크가 바뀌는 자리는 모델마다 몇 초씩 다르지만 대략 45초, 1분 25초, 2분 무렵입니다. 3.1 Flash는 두 번째 청크(49초~1분 31초)에서 두 사람 목소리가 모두 높아집니다. 이 청크의 음 높이 중앙값이 진행자 268Hz, 게스트 139Hz로, 다른 청크 평균보다 각각 약 40Hz, 25Hz 높았습니다.
읽힌 대본 - 32줄, 지난번 실시간 전사 비교 글 내용
진행자 안녕하세요! 오늘은 실시간 음성 인식 여섯 가지를 같은 녹음으로 측정해 본 이야기를 나눠 보려고 해요.
게스트 네, 반갑습니다. 한마디로 요약하면 빠른 방식일수록 고유명사를 잘못 적었다는 겁니다.
진행자 오, 흥미로운데요. 어떤 녹음으로 측정하셨어요?
게스트 팔십구 초짜리 한국어 면접 답변을 하나 녹음했어요. 틀리기 쉬운 고유명사와 숫자를 일부러 넣었고요.
진행자 틀리기 쉬운 걸 일부러 넣었다니, 꽤 짓궂은 시험이네요.
게스트 그렇죠. 말을 정정하는 대목도 있고, 추임새도 있고, 빠르게 읽는 구간도 있어요. 실제 면접처럼요.
진행자 그럼 여섯 가지 방식은 어떻게 나뉘나요?
게스트 스트리밍 두 가지, 오 초씩 잘라서 넣는 방식 두 가지, 그리고 녹음을 통째로 넣는 방식 두 가지예요.
진행자 스트리밍부터 들어 볼까요? 제일 빠른 건 어디였어요?
게스트 딥그램이 일 점 일육 초 만에 첫 글자를 띄웠어요. 다만 그건 아직 바뀔 수 있는 중간 결과였고요.
진행자 중간 결과라는 게 정확히 뭔가요?
게스트 확정하기 전에 지금까지 들은 만큼 추측해서 먼저 보여 주는 거예요. 말이 이어지면 계속 고쳐집니다.
진행자 그럼 화면에서 글자가 바뀌는 게 보이겠네요.
게스트 맞아요. 맥엔드라고 떴다가 뒷말이 들어오면서 백엔드로 바뀌는 식이에요. 오히려 확정이 더 나빠진 경우도 있었고요.
진행자 재밌네요. 다른 스트리밍 서비스는요?
게스트 카르테시아는 문장을 어디서 끊을지 제가 직접 정해야 했어요. 한국어 모델로는 서버가 알아서 끊어 주는 기능이 거절됐거든요.
진행자 그럼 이번엔 오 초 청킹 이야기를 해 볼까요?
게스트 오디오를 쌓다가 무음이 나오면 자르고, 오 초를 넘기면 가장 조용한 지점을 찾아 자르는 방식이에요. 팔십구 초가 스물세 조각으로 나뉘었습니다.
진행자 조각으로 잘라도 정확도는 괜찮았나요?
게스트 포스트그레스큐엘은 네 가지 모두 맞게 적었어요. 그런데 라이브킷은 통째로 넣은 큐웬 하나만 맞혔습니다.
진행자 통째로 넣으면 역시 더 잘 맞히는군요. 대신 느리겠죠?
게스트 네, 처리 자체는 사 초에서 팔 초면 끝나는데, 말이 다 끝나야 시작할 수 있어서 첫 글자가 구십 초가 넘어서야 나와요.
진행자 아, 그럼 실시간 자막으로는 못 쓰겠네요.
게스트 그렇죠. 그래서 둘을 같이 쓰는 방법을 권해요. 말하는 동안에는 스트리밍으로 보여 주고, 끝나면 전체를 한 번 더 돌려서 바꾸는 거예요.
진행자 좋은 방법이네요. 혹시 모든 방식이 다 틀린 단어도 있었나요?
게스트 무음이라는 단어를 여섯 중 다섯이 모음으로 적었어요. 발음이 거의 같아서 문맥으로만 구별할 수 있는 단어거든요.
진행자 문맥을 넓게 보면 풀릴 줄 알았는데 아니었군요.
게스트 네, 녹음 전체를 들은 모델도 틀렸어요. 문맥을 늘리는 것만으로는 해결되지 않는 부분이었습니다.
진행자 마지막으로 비용 이야기도 해 주세요.
게스트 카르테시아는 무료로 한 달에 다섯 시간 남짓 쓸 수 있고, 딥그램은 가입하면 이백 달러 크레딧을 줘요. 로컬 모델은 내려받기만 하면 비용이 들지 않고요.
진행자 오늘 이야기 정말 유익했습니다. 들어 주셔서 감사합니다!
게스트 감사합니다. 다음에 또 만나요!
대본 내용은 실시간 전사 여섯 가지를 비교한 글을 대화로 풀어 쓴 것입니다. 대본에는 이미 고유명사를 한글로 적어 두었습니다(포스트그레스큐엘, 라이브킷). 이유는 아래에 있습니다.
어떻게 비교했나
모두 2026-09-27에 Gemini API로 만들었습니다. 음성은 24kHz 모노이고, 한 번 호출하면 두 사람의 대화가 한 파일로 나옵니다.
| 비교 | 대본 | 횟수 | 판정 |
|---|---|---|---|
| 품질 | 6줄, 약 40초 | 3.8 3회, Lite 3회, 3.1 2회 | 모델을 가리고 gemini-3.5-flash로 채점 |
| 영어 고유명사 | 15줄, 약 1분 30초 | 모델별 2~3회 | gemini-3.5-flash·gemini-3.7-flash 두 모델로 받아쓰기 |
| 숫자와 퍼센트 | 5줄, 약 17초 | 모델별 3회 | 같은 두 모델로 받아쓰기 |
| 목소리 일관성 | 32줄, 약 3분 | 모델별 3회 | 청크별 음 높이 측정 |
듣고 판정하는 일은 사람 대신 Gemini 음성 인식 모델에 맡겼습니다. 판정 모델도 잘못 들을 수 있어서 받아쓰기는 두 모델로 따로 받았습니다. 들린 음절까지 똑같지는 않은 경우가 있었지만, 결론으로 쓴 「원래 단어로 알아볼 수 있는가, 다른 단어인가」에서는 두 모델이 모두 일치했습니다. 갈린 칸은 표에 함께 적었습니다.
3.8은 API가 바뀌었습니다
스킬의 모델 이름만 gemini-3.8-flash-tts로 바꾸고 돌리자 바로 거절됐습니다.
1
2
3
HTTP 400 INVALID_ARGUMENT
Multi-speaker generation requests must specify speech_metadata.speaker
for each text part in the contents.
3.8은 호출 방식이 통째로 달라졌습니다.
| 3.8 | 3.1 이전 | |
|---|---|---|
| 엔드포인트 | /v1beta/interactions | models/{model}:generateContent |
| 화자 지정 | 대사마다 speech_metadata.speaker 필수 | 대본 텍스트에 진행자:를 붙인다 |
| 입력 텍스트 | 적힌 글자를 그대로 읽는다. 톤은 style 필드로 | 안내문, 연기 지시를 섞어도 된다 |
| 기본 출력 | WAV(44바이트 RIFF 헤더 포함) | 헤더 없는 raw PCM(audio/l16) |
문서 원문: Migration guide (스크린샷)
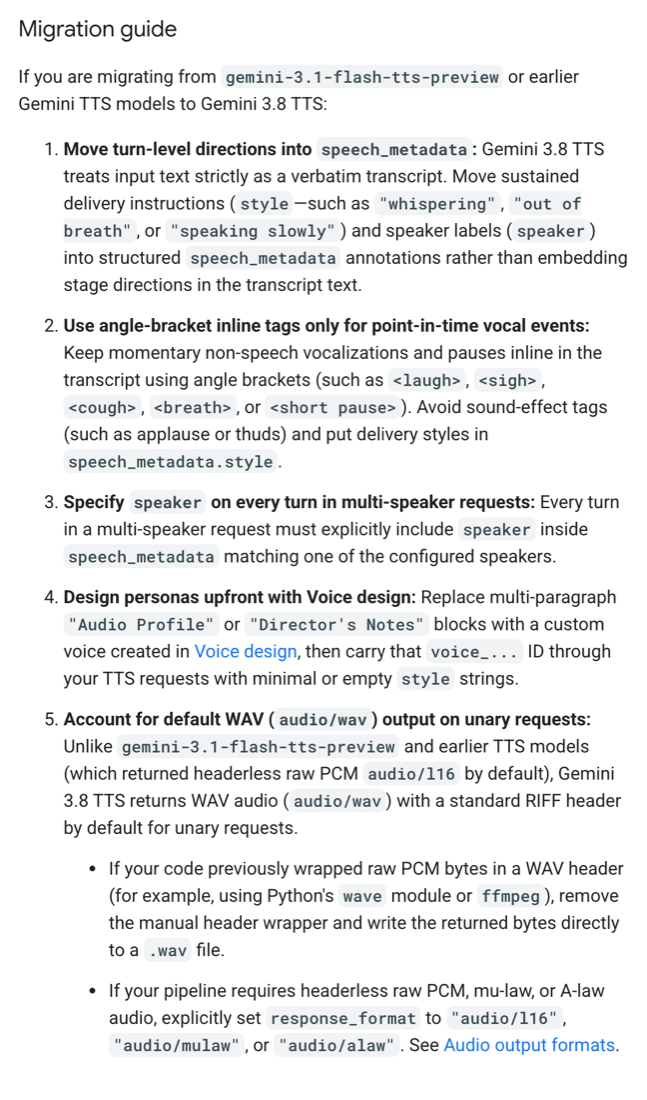 speech-generation 문서의 Migration guide 절(2026-09-27 캡처, 문서 최종 수정 2026-09-24). 5번이 기본 출력 변경이다
3.8 요청은 이렇게 생겼습니다. 대사 하나가 content 항목 하나이고, 누가 말하는지를 annotations에 답니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
{
  "model": "gemini-3.8-flash-tts",
  "input": [{"type": "user_input", "content": [
    {"type": "text", "text": "안녕하세요! 오늘은 ...",
     "annotations": [{"type": "speech_metadata", "speaker": "진행자"}]},
    {"type": "text", "text": "네, 반갑습니다. ...",
     "annotations": [{"type": "speech_metadata", "speaker": "분석가"}]}
  ]}],
  "response_format": {"type": "audio", "mime_type": "audio/l16", "sample_rate": 24000},
  "generation_config": {"speech_config": {"mode": "conversational", "speakers": [
    {"speaker": "진행자", "voice": "Leda"},
    {"speaker": "분석가", "voice": "Charon"}
  ]}}
}
기본 WAV를 모르고 이어 붙이면 청크마다 “딱” 소리가 납니다
스킬은 받은 바이트를 raw PCM으로 보고 WAV 헤더를 씌운 뒤 mp3로 바꿉니다. 3.8의 기본 응답은 이미 WAV라서 헤더가 두 번 붙고, 안쪽 헤더 44바이트가 소리로 재생됩니다. 그 상태로 파일 앞 10ms를 측정해 보니 최대 진폭이 28,006(최대치의 85%) 이었습니다. 정상 파일은 같은 구간이 3입니다. 긴 대본은 청크로 나눠 이어 붙이니 청크 수만큼 잡음이 납니다.
귀에 해로울 만큼 커서 음성은 싣지 않았습니다. 위 요청처럼 mime_type: "audio/l16"을 명시하면 예전과 같은 raw PCM이 옵니다. 문서의 제한 사항 절에도 같은 주의가 있습니다.
문서 원문: Limitations (스크린샷)
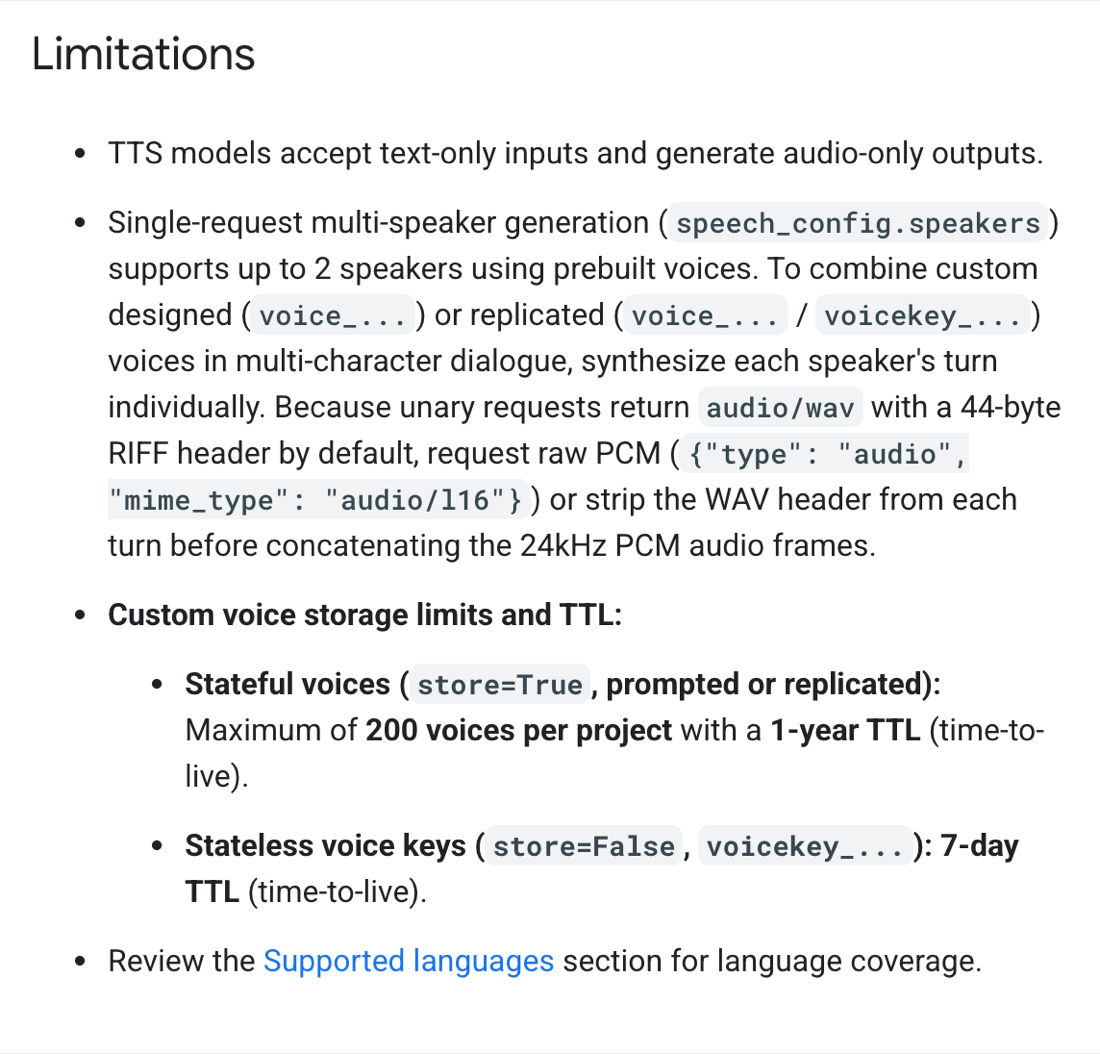 같은 문서의 Limitations 절. 둘째 항목에 44바이트 헤더 이야기와, 2편에서 다룰 복제 음성 제약이 함께 있다
비용
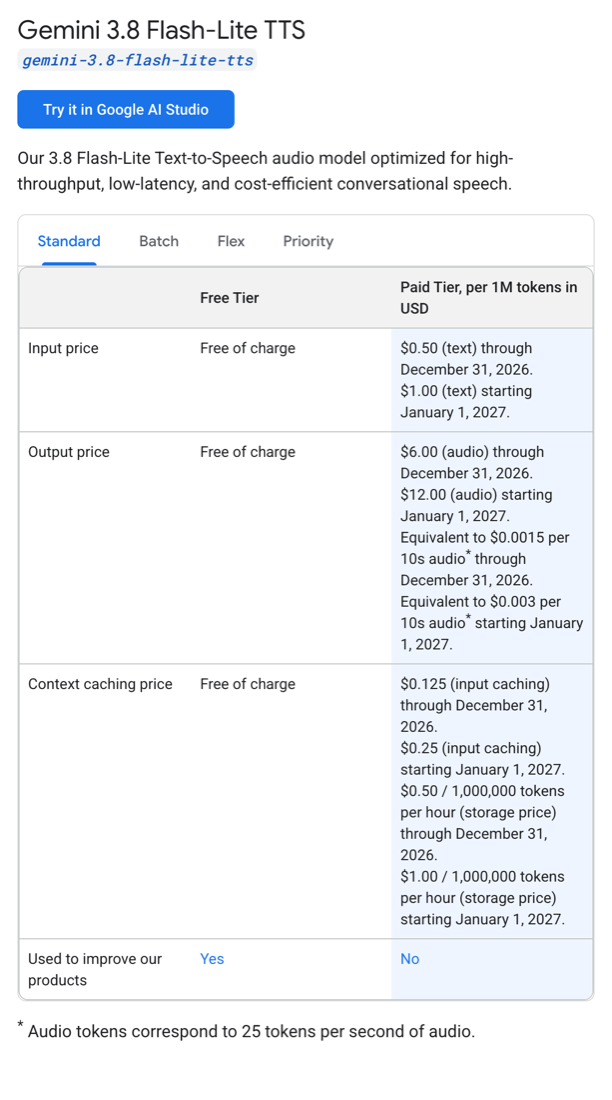
문서 원문: 가격표 (스크린샷 3장)
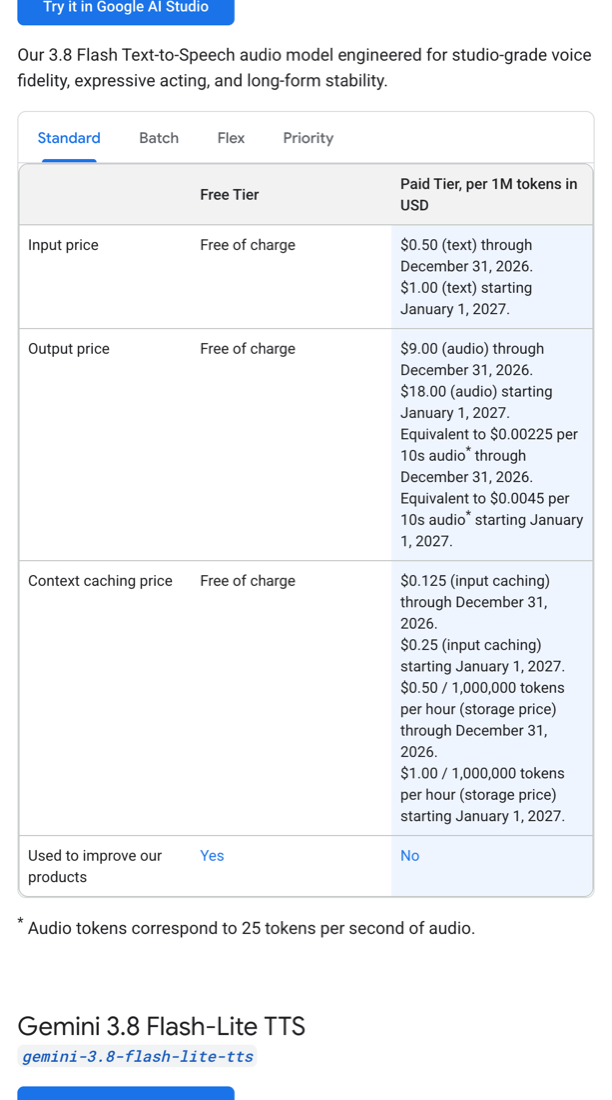 Gemini API 가격 페이지의 Gemini 3.8 Flash TTS 항목(2026-09-27 캡처). 할인 기간이 2026년 12월 31일까지로 적혀 있다
 같은 페이지의 3.8 Flash-Lite TTS 항목
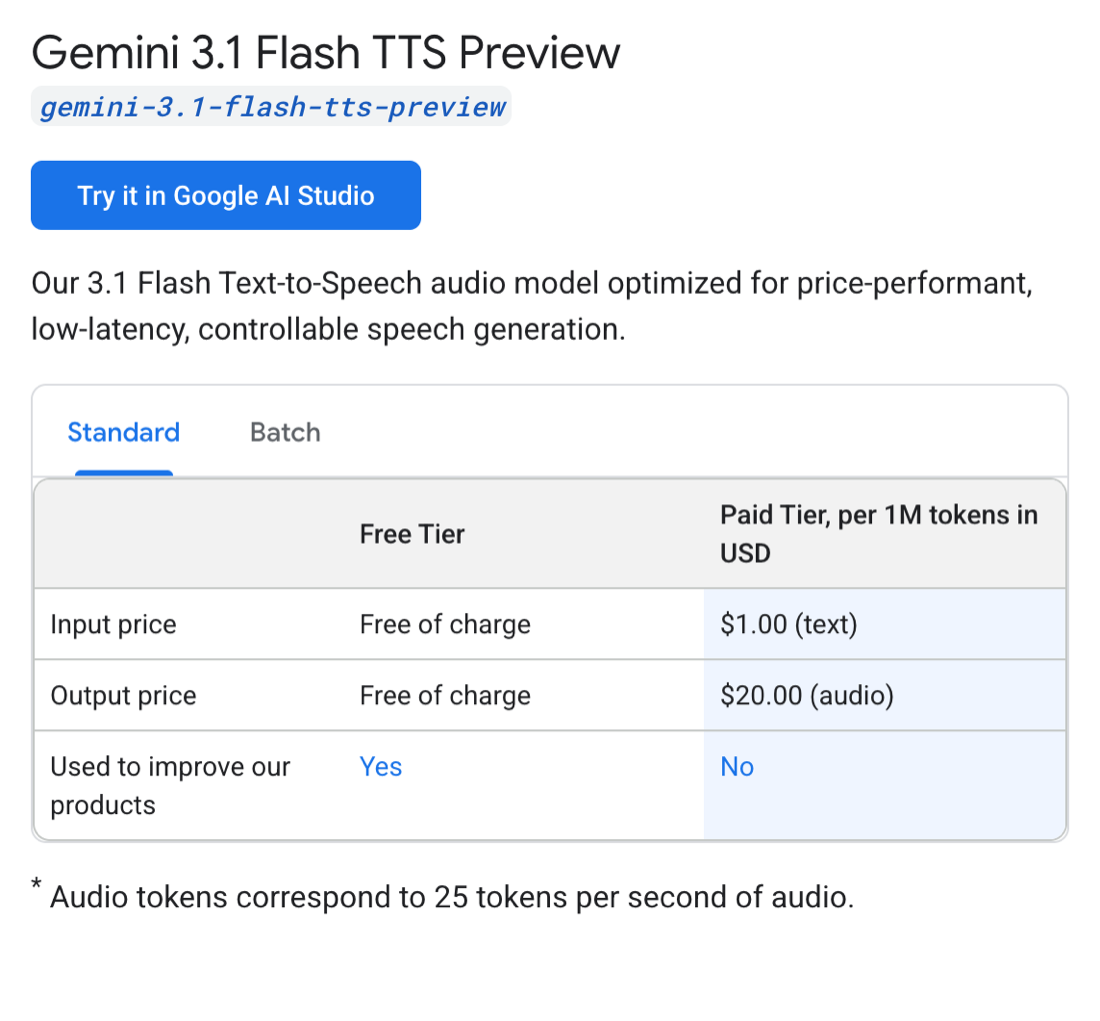 같은 페이지의 3.1 Flash TTS Preview 항목. 무료 등급은 “Used to improve our products”가 Yes다
Flash-Lite는 출력 $6(2027년부터 $12)이고, 2.5 Pro는 3.1과 같은 $20이지만 무료 등급이 없습니다. 대본(입력)은 수백 토큰이라 비용에서 무시할 수준이고, 사실상 출력 오디오 토큰이 비용입니다.
그런데 오디오 1초가 몇 토큰인지가 문서와 달랐습니다. 가격표 각주는 초당 25토큰이라고 하는데, 측정한 세 모델 모두 응답의 usage에 초당 32토큰이 찍혔습니다.
| 모델 | 음성 길이 | 출력 토큰(usage) | 초당 |
|---|---|---|---|
| 3.8 Flash | 40.1초 | 1,284 | 32.0 |
| 3.8 Flash-Lite | 40.6초 | 1,298 | 32.0 |
| 3.1 Flash | 43.2초 | 1,383 | 32.0 |
실제 청구가 어느 쪽을 따르는지는 확인하지 못했습니다. 두 기준으로 모두 환산하면 이렇습니다.
표로 보기: 1분당 비용(문서 기준 25토큰/초 환산 포함)
| 모델 | 1분(실측 32토큰/초) | 1분(문서 25토큰/초) | 22분 팟캐스트(실측) |
|---|---|---|---|
| 3.8 Flash | $0.017 (2027년 $0.035) | $0.014 ($0.027) | $0.38 ($0.76) |
| 3.8 Flash-Lite | $0.012 (2027년 $0.023) | $0.009 ($0.018) | $0.25 ($0.51) |
| 3.1 Flash, 2.5 Pro* | $0.038 | $0.030 | $0.84 |
* 2.5 Pro는 usage를 따로 측정하지 않아 단가가 같은 3.1 수치를 옮겨 적었다
이번 비교에 만든 음성은 모두 합쳐 1시간 남짓입니다. 가장 비싼 단가($20)로 계산해도 3달러가 안 됩니다.
품질: 짧은 샘플로는 구별되지 않았습니다
6줄짜리 대본(약 40초)을 모델을 가린 채 평가했습니다.
| 모델 | 점수 | 생성 시간 |
|---|---|---|
| 3.8 Flash ×3 | 8/9/10/9, 8/9/10/8, 8/9/10/8 | 17.8~19.3초 |
| 3.8 Flash-Lite ×3 | 7/9/10/8, 8/9/10/8, 8/9/10/8 | 15.1~15.6초 |
| 3.1 Flash ×2 | 8/9/10/8, 8/9/10/8 | 18.6~19.2초 |
점수는 거의 같습니다. 3.8 샘플 중 하나는 대본의 톤 지시를 style로 넣은 것인데, 점수가 달라지지 않았습니다. Lite는 2~4초 빠르고, 한 번은 자연스러움 7점을 받았습니다.
문서는 3.8 Flash를 “스튜디오급 음질, 섬세한 연기, 긴 글에서 흔들리지 않는 목소리”용으로, Flash-Lite를 “3.1을 대체하는 빠르고 싼 모델”로 소개합니다. 이번 표본으로는 그 차이를 확인하지 못했습니다.
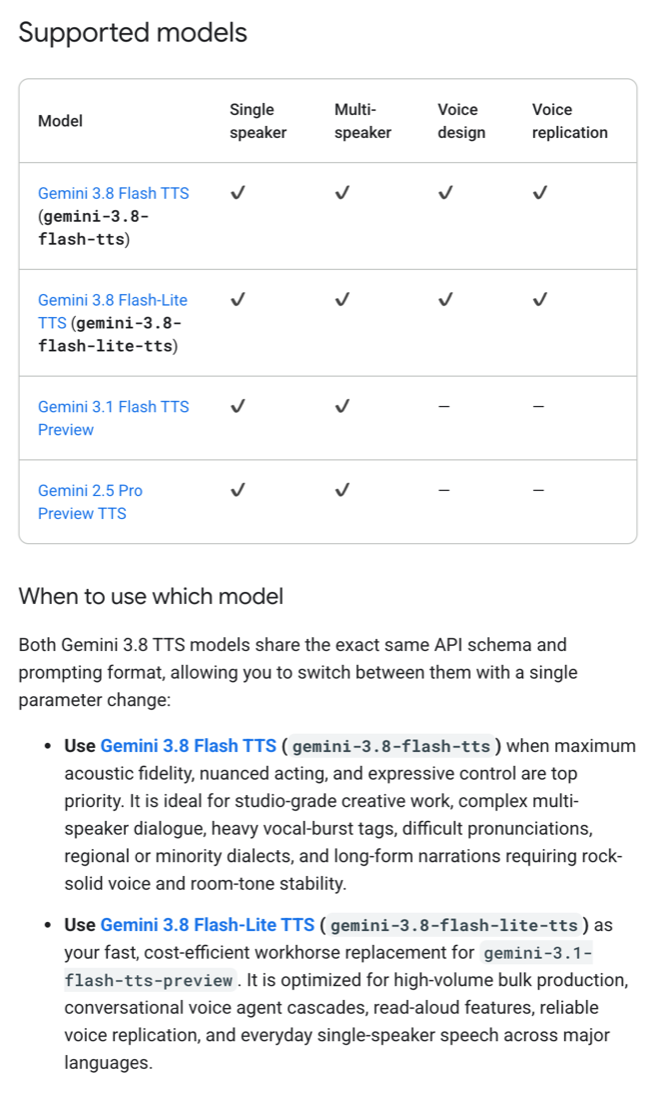
문서 원문: 지원 모델 표와 모델 선택 안내 (스크린샷)
speech-generation 문서의 Supported models 절과 When to use which model 절(2026-09-27 캡처)
영어 고유명사는 한글로 적어야 합니다
15줄 대본에 “PostgreSQL”이 두 번 나옵니다. 첫 번째 “빠른 방식일수록 PostgreSQL 같은”은 모든 모델이 매번 알아들을 수 있게 읽었습니다. 두 번째 “조각으로 잘라도 PostgreSQL은”에서 갈렸습니다.
표로 보기: 판정 모델이 들은 음절
| 모델 | 두 번째 PostgreSQL을 판정 모델 두 개가 들은 것 |
|---|---|
| 3.8 Flash ×3 | 포스트지피티, 포스트클라우드, 포스트그레스 |
3.8 Flash + 대본에 포스트그레스큐엘로 적음 ×3 | 포스트그레스큐엘 3회 |
| 3.8 Flash-Lite ×3 | 포스트그레스, 포스트그레스, 포스트그레스큐엘 · 포스트그레스그(3회차, 갈림) |
| 3.1 Flash ×2 | 포스트그레스 · 포스트그레스엘(1회차, 판정 모델끼리 갈림), 포스트그레스 |
3.8 Flash는 3회 중 2회 아예 다른 단어로 읽었습니다. 판정 모델 두 개의 결과가 같았고, 확신도는 모두 “상”이었습니다. 해당 부분만 잘라 두었습니다.
3.8 Flash, 1회차 - 「포스트지피티」로 들린다
3.8 Flash, 2회차 - 「포스트클라우드」 또는 「포스트클라운」으로 들린다
3.8 Flash, 대본에 한글로 적었을 때 - 「포스트그레스큐엘」
3.8 Flash-Lite - 「포스트그레스」
3.1 Flash - 「포스트그레스엘」
같은 대본 안에서도 한 번은 맞고 한 번은 틀렸으니, 한 번 맞았다고 안심할 수 없습니다. 대본에 영어 고유명사를 쓰지 않고 한글 발음으로 적는 것이 가장 확실합니다. 위의 비교용 팟캐스트 대본도 그렇게 썼습니다.
숫자와 퍼센트는 문제없었습니다
지난 9월 2일에 3.1 Flash가 대본의 “퍼센트”를 “프로”로 바꿔 읽는 것을 본 적이 있습니다. 같은 형식(숫자를 한글로 적은 대본)으로 “삼십 퍼센트”, “십오 퍼센트”, “일억 원”, “육십 퍼센트”를 넣어 네 모델을 3회씩 만들었습니다.
12개 모두 “퍼센트”로 읽었습니다. “일억”은 11개에서 두 판정 모델 모두 「일억」으로 들었고, 2.5 Pro 한 개는 한 모델이 「이억」, 다른 모델이 「일억」으로 들어 판정이 갈렸습니다. 당시에도 다시 만들면 제대로 읽었던 확률적인 문제라, 이번 3회에서는 재현되지 않았다고만 적어 둡니다. 숫자는 대본에 아라비아 숫자(30%) 대신 한글(삼십 퍼센트)로 적는 편이 안전합니다.
목소리 일관성: 진행자만 나아졌습니다
예전 모델로 팟캐스트를 만들면 목소리가 일관되지 않다는 느낌이 있었습니다. 이것을 두 가지로 나눠 측정했습니다. 한 편 안에서 청크끼리 목소리가 달라지는지, 그리고 같은 대본을 다시 만들 때마다 목소리가 달라지는지입니다.
32줄 대본을 청크 네 개로 나눠 모델마다 세 번씩 만들고, 청크마다 화자별 음 높이(F0) 중앙값을 구했습니다. 진행자는 여성, 게스트는 남성 목소리라 160Hz를 기준으로 두 사람을 갈랐습니다. 한 편 안에서 가장 높은 청크와 가장 낮은 청크가 몇 % 벌어지는지를 봤습니다. 10%는 약 1.7반음, 20%는 약 3.2반음입니다.
표로 보기: 최악값과 다시 만들 때 차이 포함
| 모델 | 청크끼리 평균 | 청크끼리 최악 | 다시 만들 때 |
|---|---|---|---|
| 3.8 Flash | 8.2% / 15.6% | 11.5% / 22.6% | 2.4% / 1.2% |
| 3.8 Flash-Lite | 5.9% / 12.6% | 8.1% / 22.5% | 4.2% / 6.4% |
| 3.1 Flash | 11.8% / 14.9% | 20.1% / 25.3% | 4.2% / 1.1% |
| 2.5 Pro | 6.1% / 6.7% | 9.8% / 8.2% | 4.1% / 2.5% |
각 칸은 진행자 / 게스트다. 모델별 3회, 회차마다 청크 4개이고, 같은 대본을 같은 경계로 나눴으므로 청크 내용은 모델끼리 같다. 「다시 만들 때」는 세 회차의 편 평균 음 높이가 서로 벌어진 정도다
- 가장 안정적인 건 가장 오래된 2.5 Pro입니다. 두 사람 모두 10%를 넘은 적이 없습니다.
- 3.8 Flash는 진행자가 3.1보다 안정됐습니다(평균 11.8% → 8.2%, 최악 20% → 11.5%).
- 남성 게스트는 3.8에서도 그대로입니다(평균 14.9% → 15.6%). 한 회차에서는 청크별 중앙값이 108, 121, 106, 96Hz로 움직였습니다.
- 목소리를 바꾸면 달라집니다. 한국어 목소리와 Voice design 목소리로 같은 시험을 한 결과는 3편에 있습니다.
- 다시 만들 때의 차이는 청크끼리보다 작습니다. 편 평균으로 보면 모든 모델이 1~6% 안이고, 3.8 Flash가 2.4%, 1.2%로 가장 작았습니다. 흔들림은 주로 한 편 안에서 청크가 바뀔 때 생깁니다.
문서에도 목소리 일관성을 다룬 절이 있습니다. 흔들림의 가장 흔한 원인으로 예전 모델에서 쓰던 긴 연기 지시문을 꼽고, Voice design으로 목소리를 만들어 그 voice_... ID를 계속 쓰라고 권합니다. 이 스킬은 원래 연기 지시를 넣지 않으니, 문서가 말한 원인은 해당하지 않습니다. 그래도 설계한 목소리로 바꾸면 달라지는지 3편에서 해 봤는데, 줄지 않았습니다.
문서 원문: Consistency across generations (스크린샷)
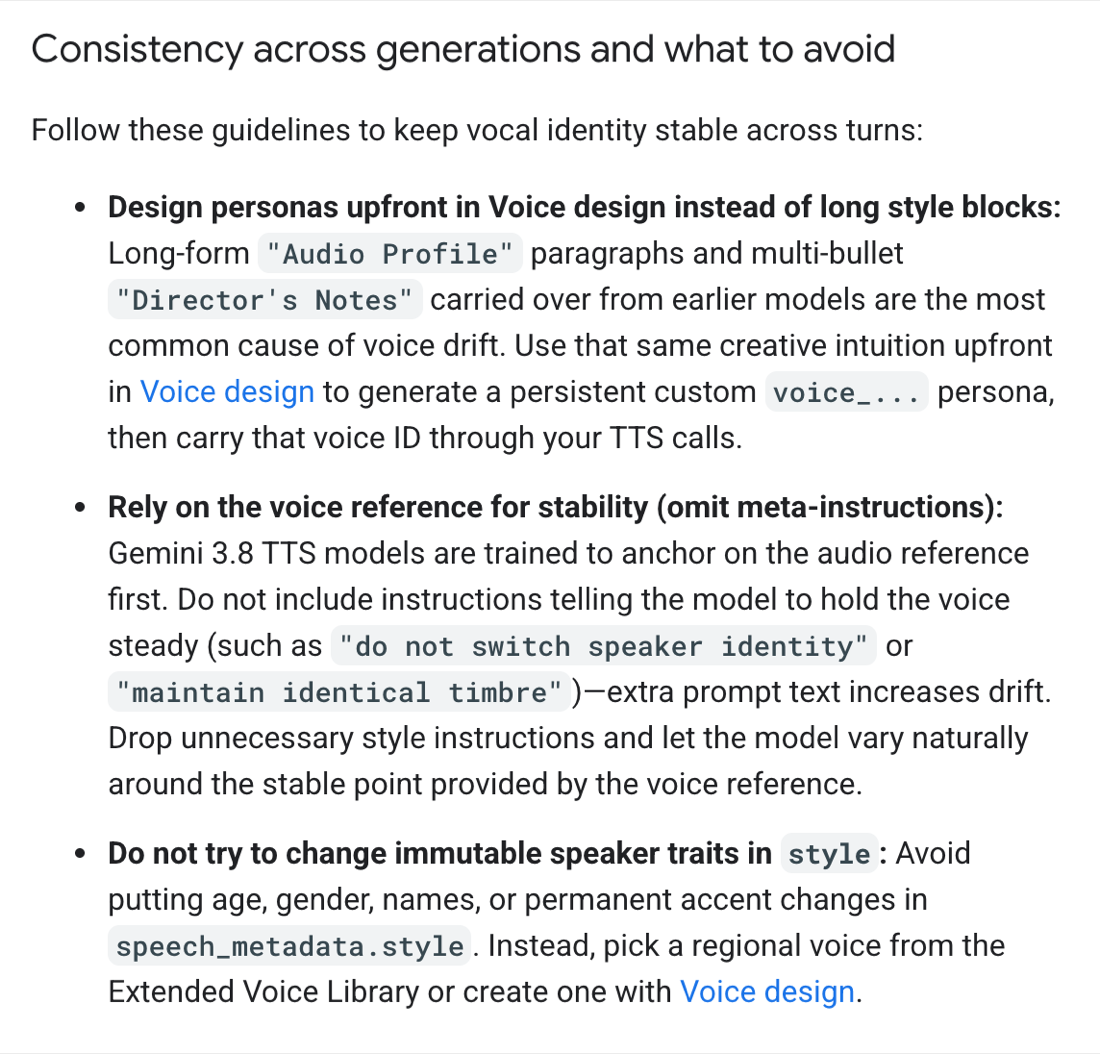 speech-generation 문서 Prompting guide의 Consistency across generations and what to avoid 절(2026-09-27 캡처)
이 측정의 한계도 적어 둡니다. 음 높이는 억양과 감정에 따라서도 달라지므로 “같은 사람처럼 들리는가”를 전부 설명하지 못합니다. 경계를 늘리려고 청크를 300자로 잘게 나눴는데, 스킬 기본값(620자)에서는 경계가 절반으로 줄어듭니다. 판정 모델에게 들려주고 일관성을 물었을 때는 16건 중 14건이 두 사람 모두 10점이었고, 낮은 점수를 준 2건은 다른 판정 모델이 10점을 줘서 청취 판정은 근거로 쓰지 않았습니다. 위의 샘플로 직접 들어 보시는 게 가장 정확합니다.
그래서 무엇을 쓸까
- 보통 팟캐스트라면 3.8 Flash를 씁니다. 가격이 절반 이하이고 품질 차이는 구별되지 않았습니다. 스킬 기본값도 이것으로 바꿨습니다. 대본의 영어 고유명사는 한글로 적습니다.
- 한국어 대본이면 한국어 목소리(
ko-kr-podcaster-*등)를 시험해 볼 만합니다. 기본 목소리 Leda와 Charon은 미국 영어 목소리입니다(3편). - 많이, 싸게 만들 거라면 3.8 Flash-Lite입니다. 3.8 Flash보다 33% 싸고 40초 분량 기준 2~4초 빠르며, 이번에는 PostgreSQL도 3회 모두 알아듣게 읽었습니다. API가 같아서 모델 이름만 바꾸면 됩니다.
- 청크 사이 목소리가 흔들리는 게 가장 거슬린다면 2.5 Pro입니다. 가장 비싸고(3.1과 같은 $20) 무료 등급이 없으며 문서상 이전 모델이지만, 이번 측정에서 가장 안정적이었습니다.
- 내 목소리로 만들고 싶다면 3.8 Flash로 복제를 만들고 Flash 또는 Flash-Lite로 읽습니다(2편).
읽을 때 감안할 점
- 표본이 작습니다. 품질은 40초 샘플을 모델당 2~3개, 고유명사는 2~3회, 일관성은 3회 만들어 본 결과입니다.
- 판정을 모델에게 맡겼습니다. 사람이 들은 결과가 아니고, 판정 모델도 틀립니다. 받아쓰기는 두 판정 모델로 따로 받아, 「알아볼 수 있는가, 다른 단어인가」에서 둘이 일치한 것만 결론으로 썼습니다.
- 대본이 하나의 주제입니다. 기술 용어가 많은 한국어 대화 한 종류로만 비교했습니다.