빠른 판단과 구조화 결정을 위한 System 1 AI 모델, TypeSafe Jev 살펴보기 및 실전 테스트
최근 AI 엔지니어링 커뮤니티에서 TypeSafe AI의 신규 모델 Jev(제브)가 큰 화제를 모으고 있습니다. 기존 거대 언어 모델(LLM)들이 텍스트를 한 글자씩 순차적으로 생성(Autoregressive)하는 방식이었다면, Jev는 문장 생성을 완전히 건너뛰고 “소프트웨어가 즉시 소비할 수 있는 타입화된 결정과 확률”만을 단일 패스로 뽑아내는 새로운 형태의 모델입니다.
단순히 빠른 결정(스팸 판정, 에이전트 가드레일, 모델 라우팅 등)이 필요한데 기존 LLM은 응답이 너무 느리거나, JSON 등 Structured Output을 요청했을 때 문법이 깨져서 파싱 에러를 겪었던 개발자들에게 Jev는 매우 매력적인 대안으로 떠오르고 있습니다.
이번 글에서는 Jev의 핵심 아키텍처와 배경, 관련 생태계를 리서치하고, 실제 발급받은 API 키로 고객 문의 자동 분류/모델 라우터 및 에이전트 도구 호출 안전 가드레일 프로젝트를 직접 구축하여 검증한 실측 결과를 공유합니다.
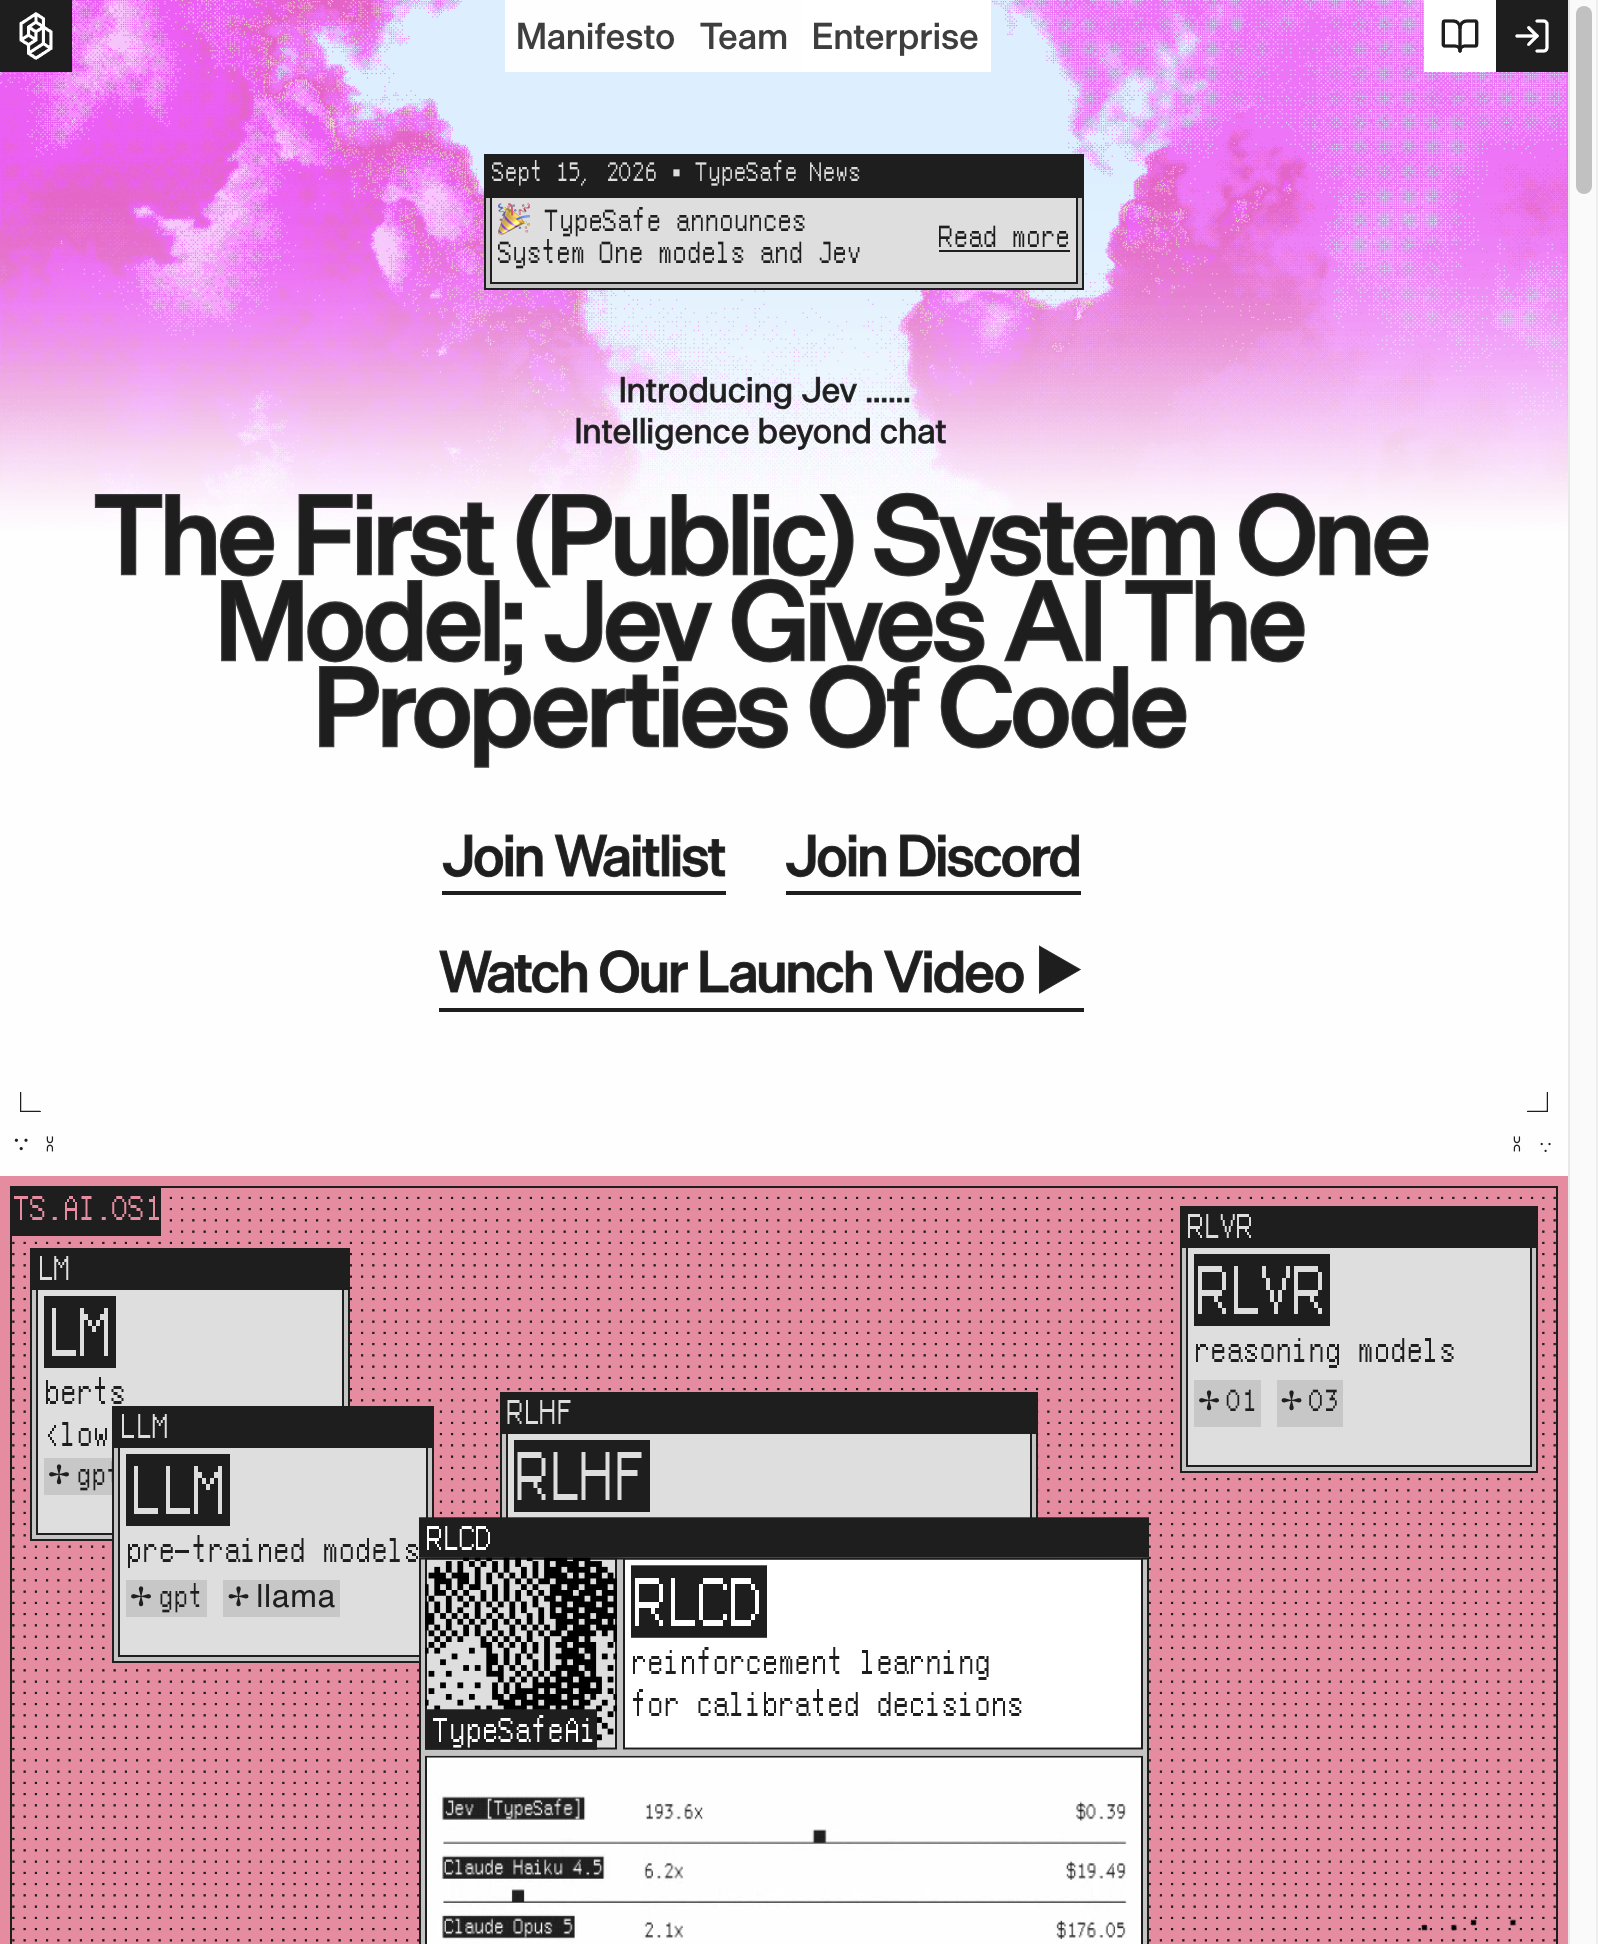 TypeSafe AI 공식 홈페이지 (typesafe.ai) — 소프트웨어 내부의 의사결정을 위한 머신 네이티브 인텔리전스
1. Jev와 “System One” 모델이란 무엇인가?
Jev는 OpenAI에서 RLHF, ChatGPT, InstructGPT 개발에 핵심적으로 참여했던 디오고 알메이다(Diogo Almeida)가 설립한 TypeSafe AI가 2026년 9월 스텔스에서 벗어나며 공개한 첫 번째 프론티어 모델입니다 (DCVC 주도 4,000만 달러 시드 투자 유치).
TypeSafe AI는 이 모델군을 대니얼 카너먼(Daniel Kahneman)의 저서 《생각에 관한 생각(Thinking, Fast and Slow)》에서 이름을 따와 “시스템 1(System One)” 모델이라고 부릅니다.
- 시스템 2 (기존 LLM - GPT-4o, Claude 3.5 Sonnet 등): 깊이 생각하고, 논리를 전개하며, 문장과 코드를 단계적으로 작성하는 느리고 무거운 추론형 AI.
- 시스템 1 (Jev): 직관적이고 즉각적인 판단(“이 메시지는 스팸인가?”, “이 요청은 결제 부서로 보낼 것인가?”, “이 셸 명령어는 위험한가?”)을 수십~수백 밀리초 만에 내리는 경량 고속 판단형 AI.
기존 소프트웨어 개발자들은 단순한 카테고리 분류나 가드레일 체크를 위해서도 비싸고 느린 시스템 2 LLM을 호출해야 했습니다. 하지만 현실의 애플리케이션 루프에서는 장황한 설명문보다 “정확하고 빠른 하나의 분기 결정”이 훨씬 더 자주 필요합니다.
기존 LLM 대비 주요 특징 비교
| 비교 항목 | TypeSafe Jev (System 1) | 일반 프론티어 LLM (System 2) |
|---|---|---|
| 추론 방식 | 비생성형 (Non-Autoregressive, 단일 순전파) | 순차적 토큰 생성 (Autoregressive) |
| 응답 지연시간 | 70ms ~ 500ms (내부 연산 기준) | 2초 ~ 30초 이상 |
| 입력 토큰 가격 | $0.042 / 100만 토큰 | $0.20 ~ $15.00 / 100만 토큰 |
| 출력 토큰 가격 | 무료 ($0, Too cheap to meter) | 입력 대비 3~5배 비쌈 |
| Structured Output 오류 | 구조적으로 0% (스키마 강제) | 0.5% ~ 15% (파싱/포맷 깨짐 발생) |
| 텍스트/코드 작문 | 불가 (의도적으로 지원하지 않음) | 뛰어남 |
💡 핵심 요약: Jev는 자유 형식의 글을 쓰지 못합니다. 대신 주어진 상태(State)를 바탕으로 우리가 정의한 질문들에 대해 단 한 번의 요청으로 병렬 평가를 끝내고, 각 선택지의 확률(Probabilities)과 신뢰도(Confidence)를 담은 JSON을 확정적으로 돌려줍니다.
2. Jev의 세 가지 질문 프리미티브 (Questions)
Jev API는 컨텍스트가 되는 state(일반 문자열뿐 아니라 JSON 객체, 로그, 배열 등 어떤 데이터든 가능)와 함께 다음 세 가지 형태의 질문을 조합하여 전달받습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
{
  "state": "...",
  "model": "jev-latest",
  "questions": {
    "is_urgent": { "type": "noul", "instructions": "긴급한 요청입니까?" },
    "category": {
      "type": "choice",
      "instructions": "분류 항목을 선택하세요.",
      "criteria": { "billing": "결제", "tech": "기술", "general": "일반" }
    },
    "risk_level": {
      "type": "score",
      "instructions": "위험도를 0~2 단계로 평가하세요.",
      "criteria": ["안전", "주의", "위험"]
    }
  }
}
Noul(이진 확률 질문): Yes / No 성격의 질문입니다. ‘Yes’에 해당하는 확률(0.0 ~ 1.0)을 부동소수점 값으로 반환합니다.Choice(다지선다 분류): 정의된 옵션 셋(최대 255개) 중 하나를 선택합니다. 선택된choice값과 함께 각 옵션별 확률 분포(probabilities) 및 판정confidence를 제공합니다.Score(단계적 평점): 2개에서 10개 수준의 순서가 있는 기준(criteria)에 따라 연속적인 평가 점수(score)와 신뢰도를 반환합니다.
모든 질문은 독립적이면서도 동일한 state에 대해 단일 패스로 병렬 평가되므로 질문 개수를 여러 개 늘려도 응답 시간에 큰 차이가 없습니다.
3. 서비스 접근성 및 생태계 검증
3.1 웨이팅리스트 및 $5 월간 크레딧
- 공식 사이트: https://typesafe.ai/
- 현재 웨이팅리스트를 운영 중이지만, 등록하면 보통 하루 만에 승인 이메일이 옵니다.
- 가입 완료 시 한 달에 $5 상당의 크레딧을 받게 됩니다.
- 100만 입력 토큰당 $0.042에 불과하므로, $5 크레딧이면 약 1억 1,900만 토큰을 처리할 수 있습니다. 웬만한 개발 테스트와 개인 프로젝트에서는 실질적으로 무제한에 가깝게 쓸 수 있는 양입니다.
3.2 OpenRouter 지원 현황
- 모델 링크:
- OpenRouter에서도 2026년 9월 17일 정식 등록되어 통합 API 키로 바로 호출할 수 있습니다.
- OpenRouter Labs(openrouter.ai/labs/jev)에는 Jev 기반의 툴 호출 검증, 실시간 보드 추격 게임, 스트리밍 음성 비서 게이팅 등의 오픈 레시피가 공개되어 있습니다.
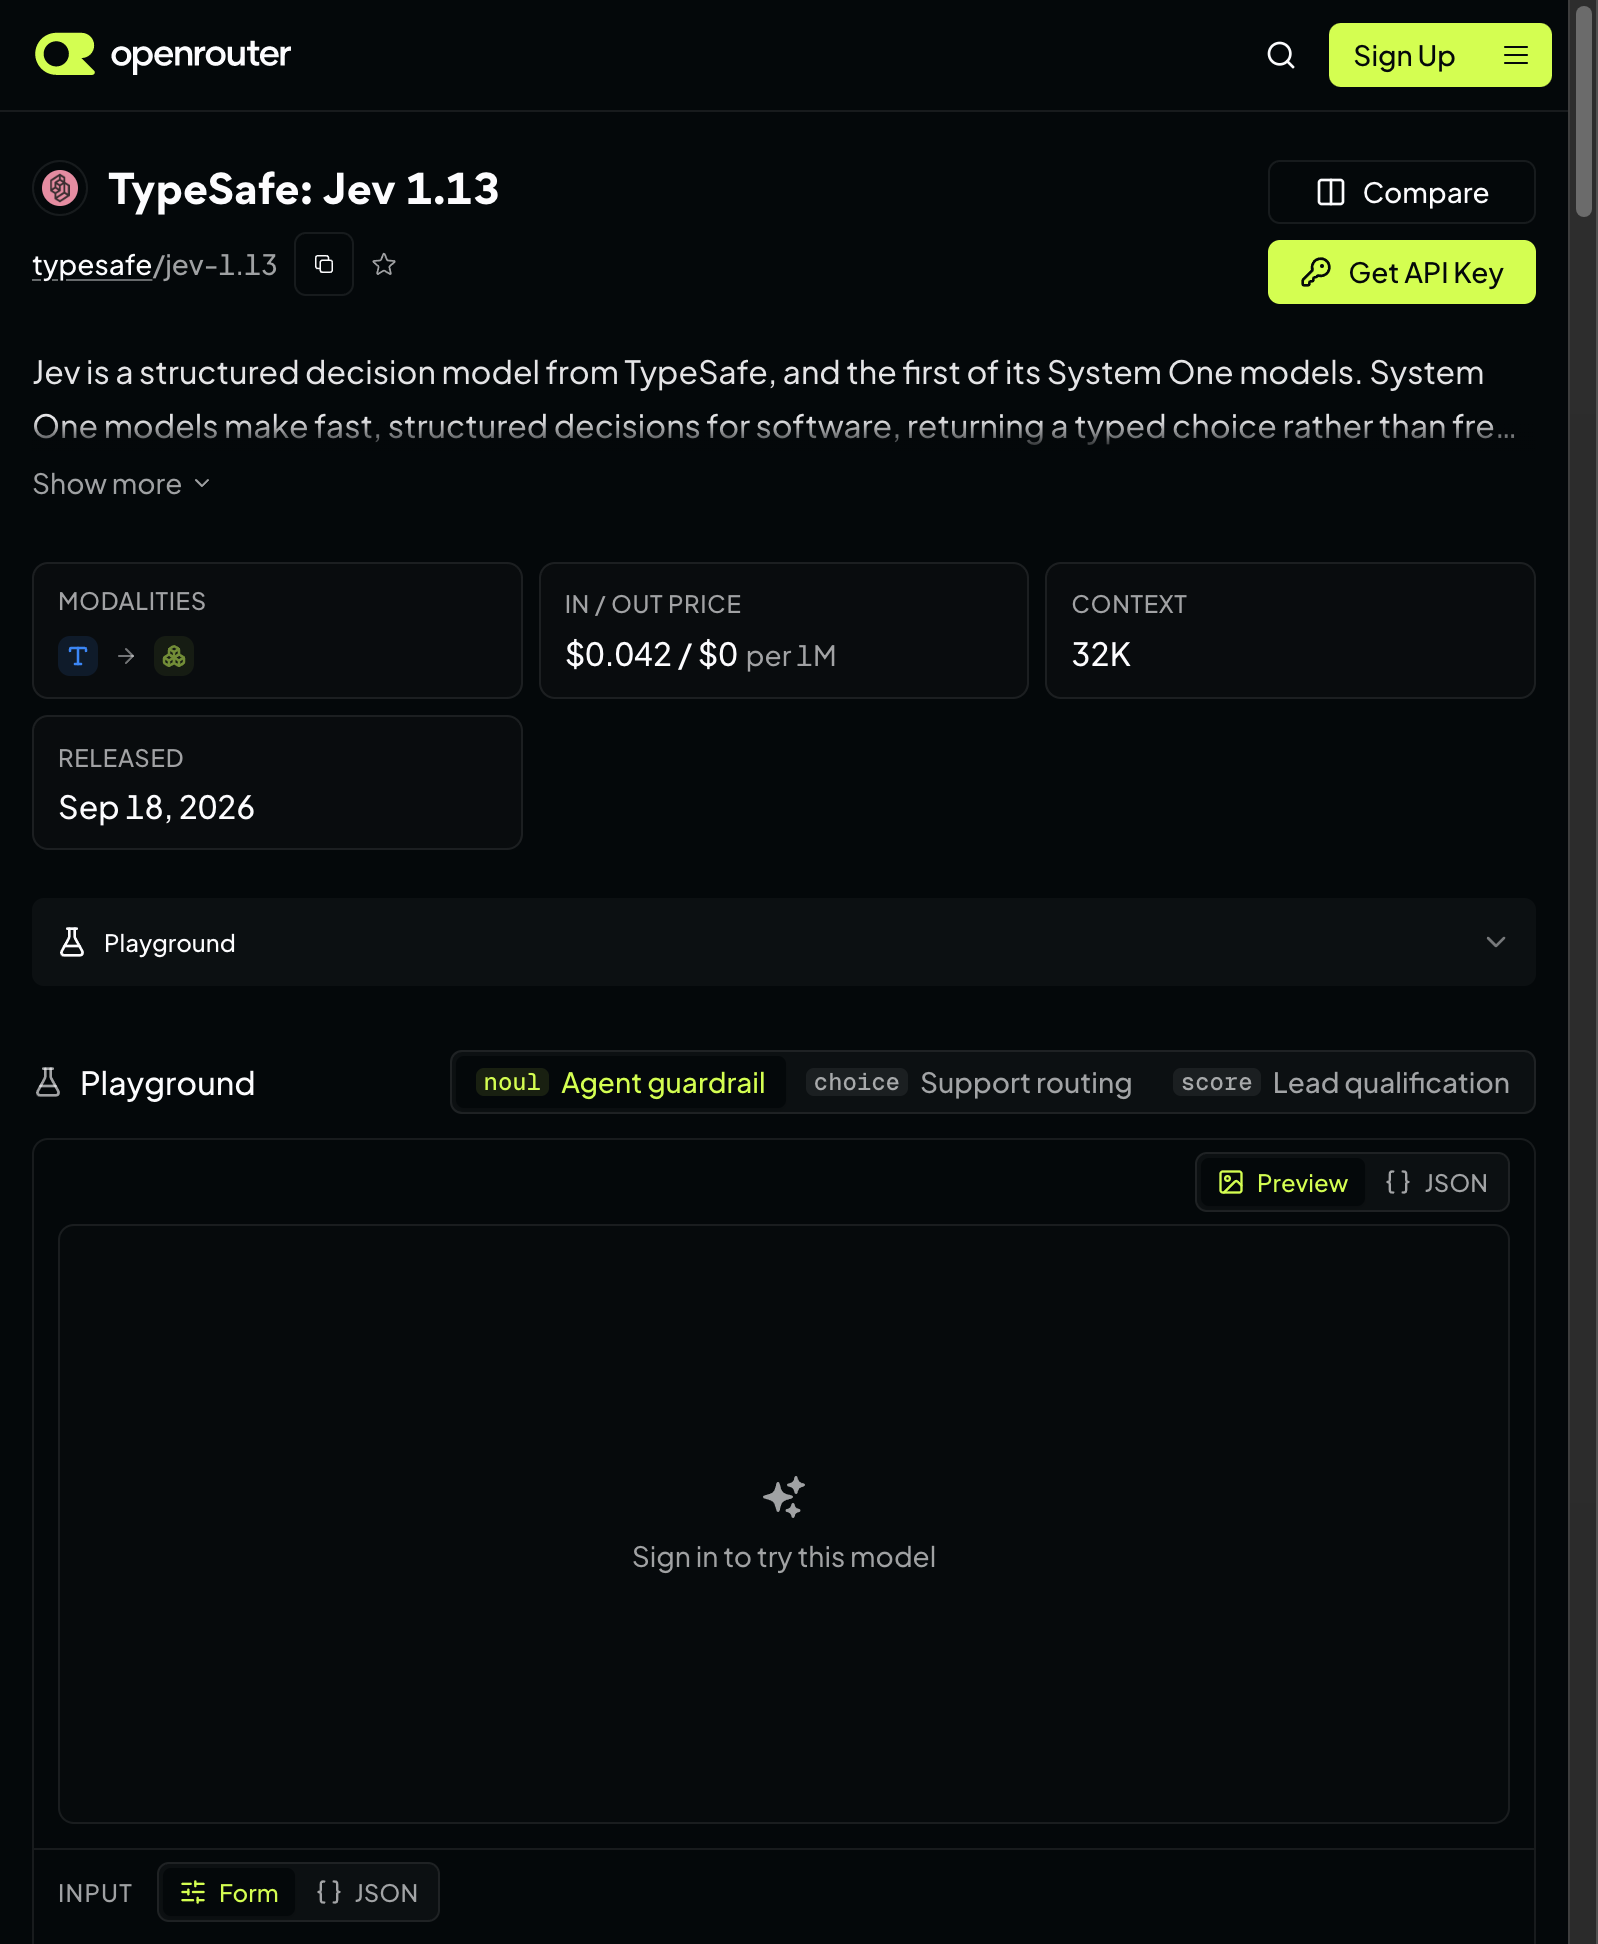 OpenRouter에 등록된 TypeSafe Jev 1.13 — 입력 1M당 $0.042, 출력 $0 정책이 동일하게 명시되어 있습니다.
3.3 다양한 활용 사례 쇼케이스: Jevable
- 사이트: https://jevable.com/
- Jev가 출시된 지 불과 며칠 만에 350개 이상의 커뮤니티 프로젝트가 등록되었습니다.
- 주요 프로젝트:
- 시맨틱 서킷 브레이커(Semantic Circuit Breaker): 에이전트 루프가 헛돌거나 이상 행동을 보일 때 동작을 차단하는 안전장치
- 스마트 이메일/폼 필터: 입력 폼 작성 중 실시간으로 필드 유효성 및 맥락 판정
- 카탄(Catan) 및 Doom 플레이어: 복잡한 텍스트 생성 없이 즉각적인 액션 logits만 판별하여 게임을 진행하는 에이전트
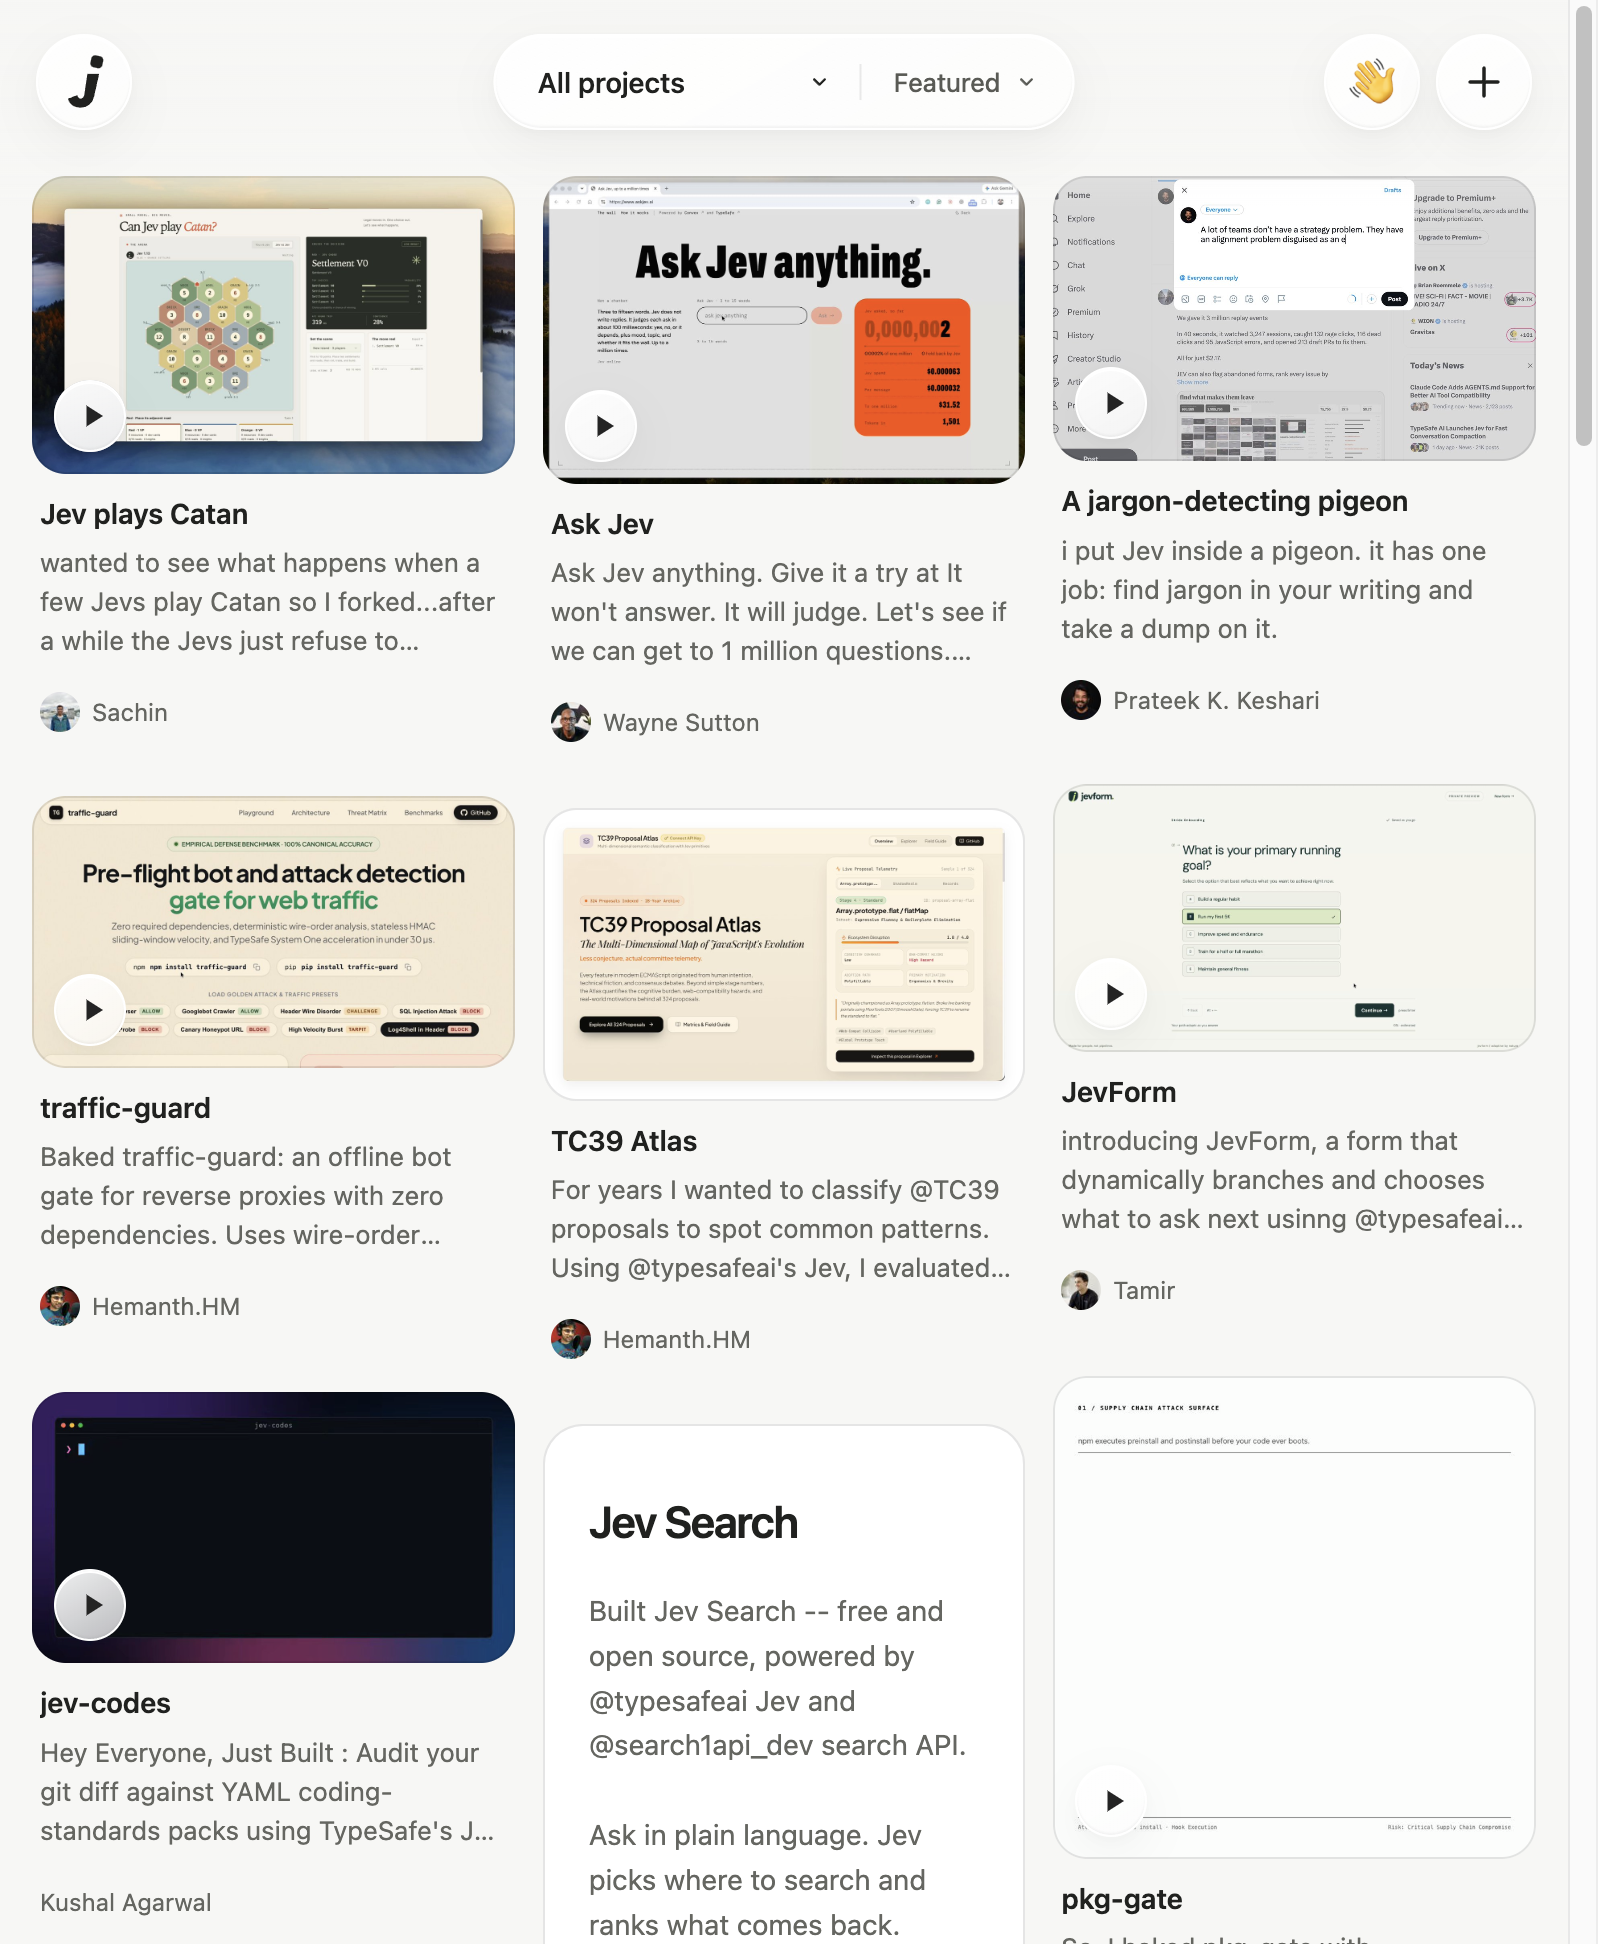 Jevable (jevable.com) — Jev를 활용한 수백 개의 프로젝트와 아이디어 모음
3.4 오픈소스 및 대안 모델들의 등장
Jev의 아키텍처적 접근 방식이 주목받으면서 비슷한 철학의 오픈소스 프로젝트와 온디바이스 모델들도 빠르게 확산되고 있습니다.
① SemIf (구 OpenJev) — 브라우저 로컬 실행
- 사이트: https://openjev.com/
- 클라우드 API를 쓰지 않고 브라우저 WebGPU 환경에서 오픈 가중치 모델(MiniCPM, Qwen 등)을 활용해 허용된 옵션의 logit 확률을 직접 계산하는 독립 연구 프로젝트입니다.
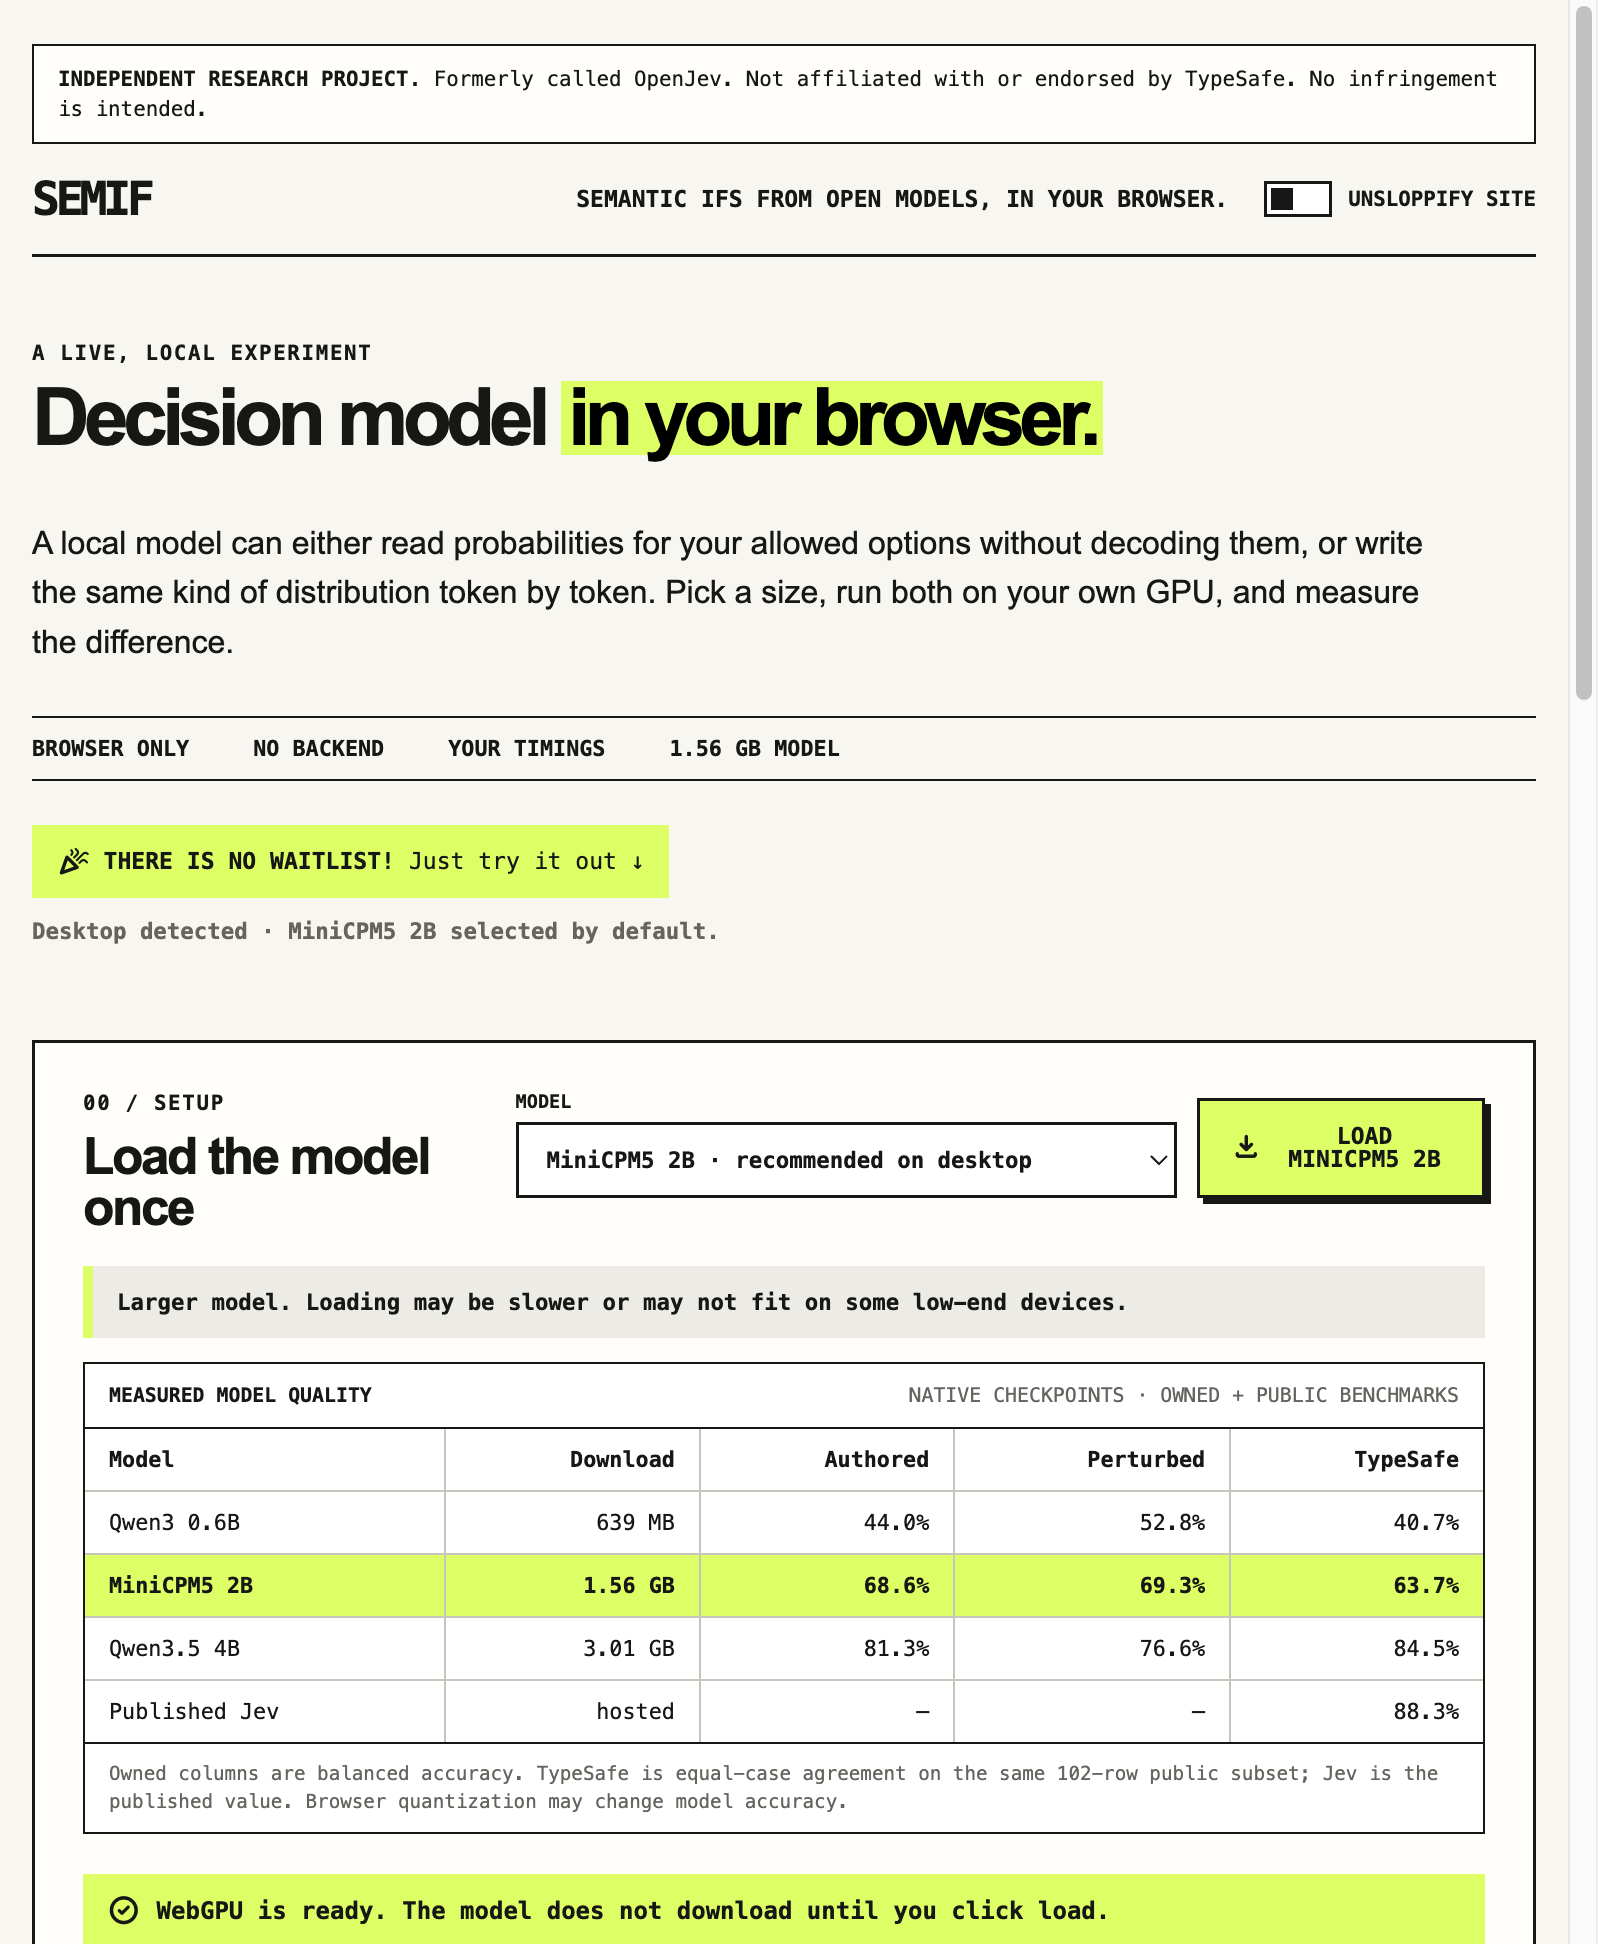 OpenJev에서 개명된 SemIf — WebGPU를 통해 브라우저 로컬에서 의미론적 분기(Semantic If)를 시험할 수 있습니다.
② Cactus Compute의 Needle — 초경량 온디바이스 모델
- 사이트: https://cactuscompute.com/needle
- Cactus Compute에서 내놓은 Needle(니들) 2/3는 모바일과 IoT, 임베디드 장치에 맞춘 8MB~29MB 크기의 45M 파라미터 모델입니다.
- 작은 램 용량(28MB RAM)에서 동작하면서 도구 호출(Tool calling) 및 구조화 데이터 추출에 집중된 모델입니다.
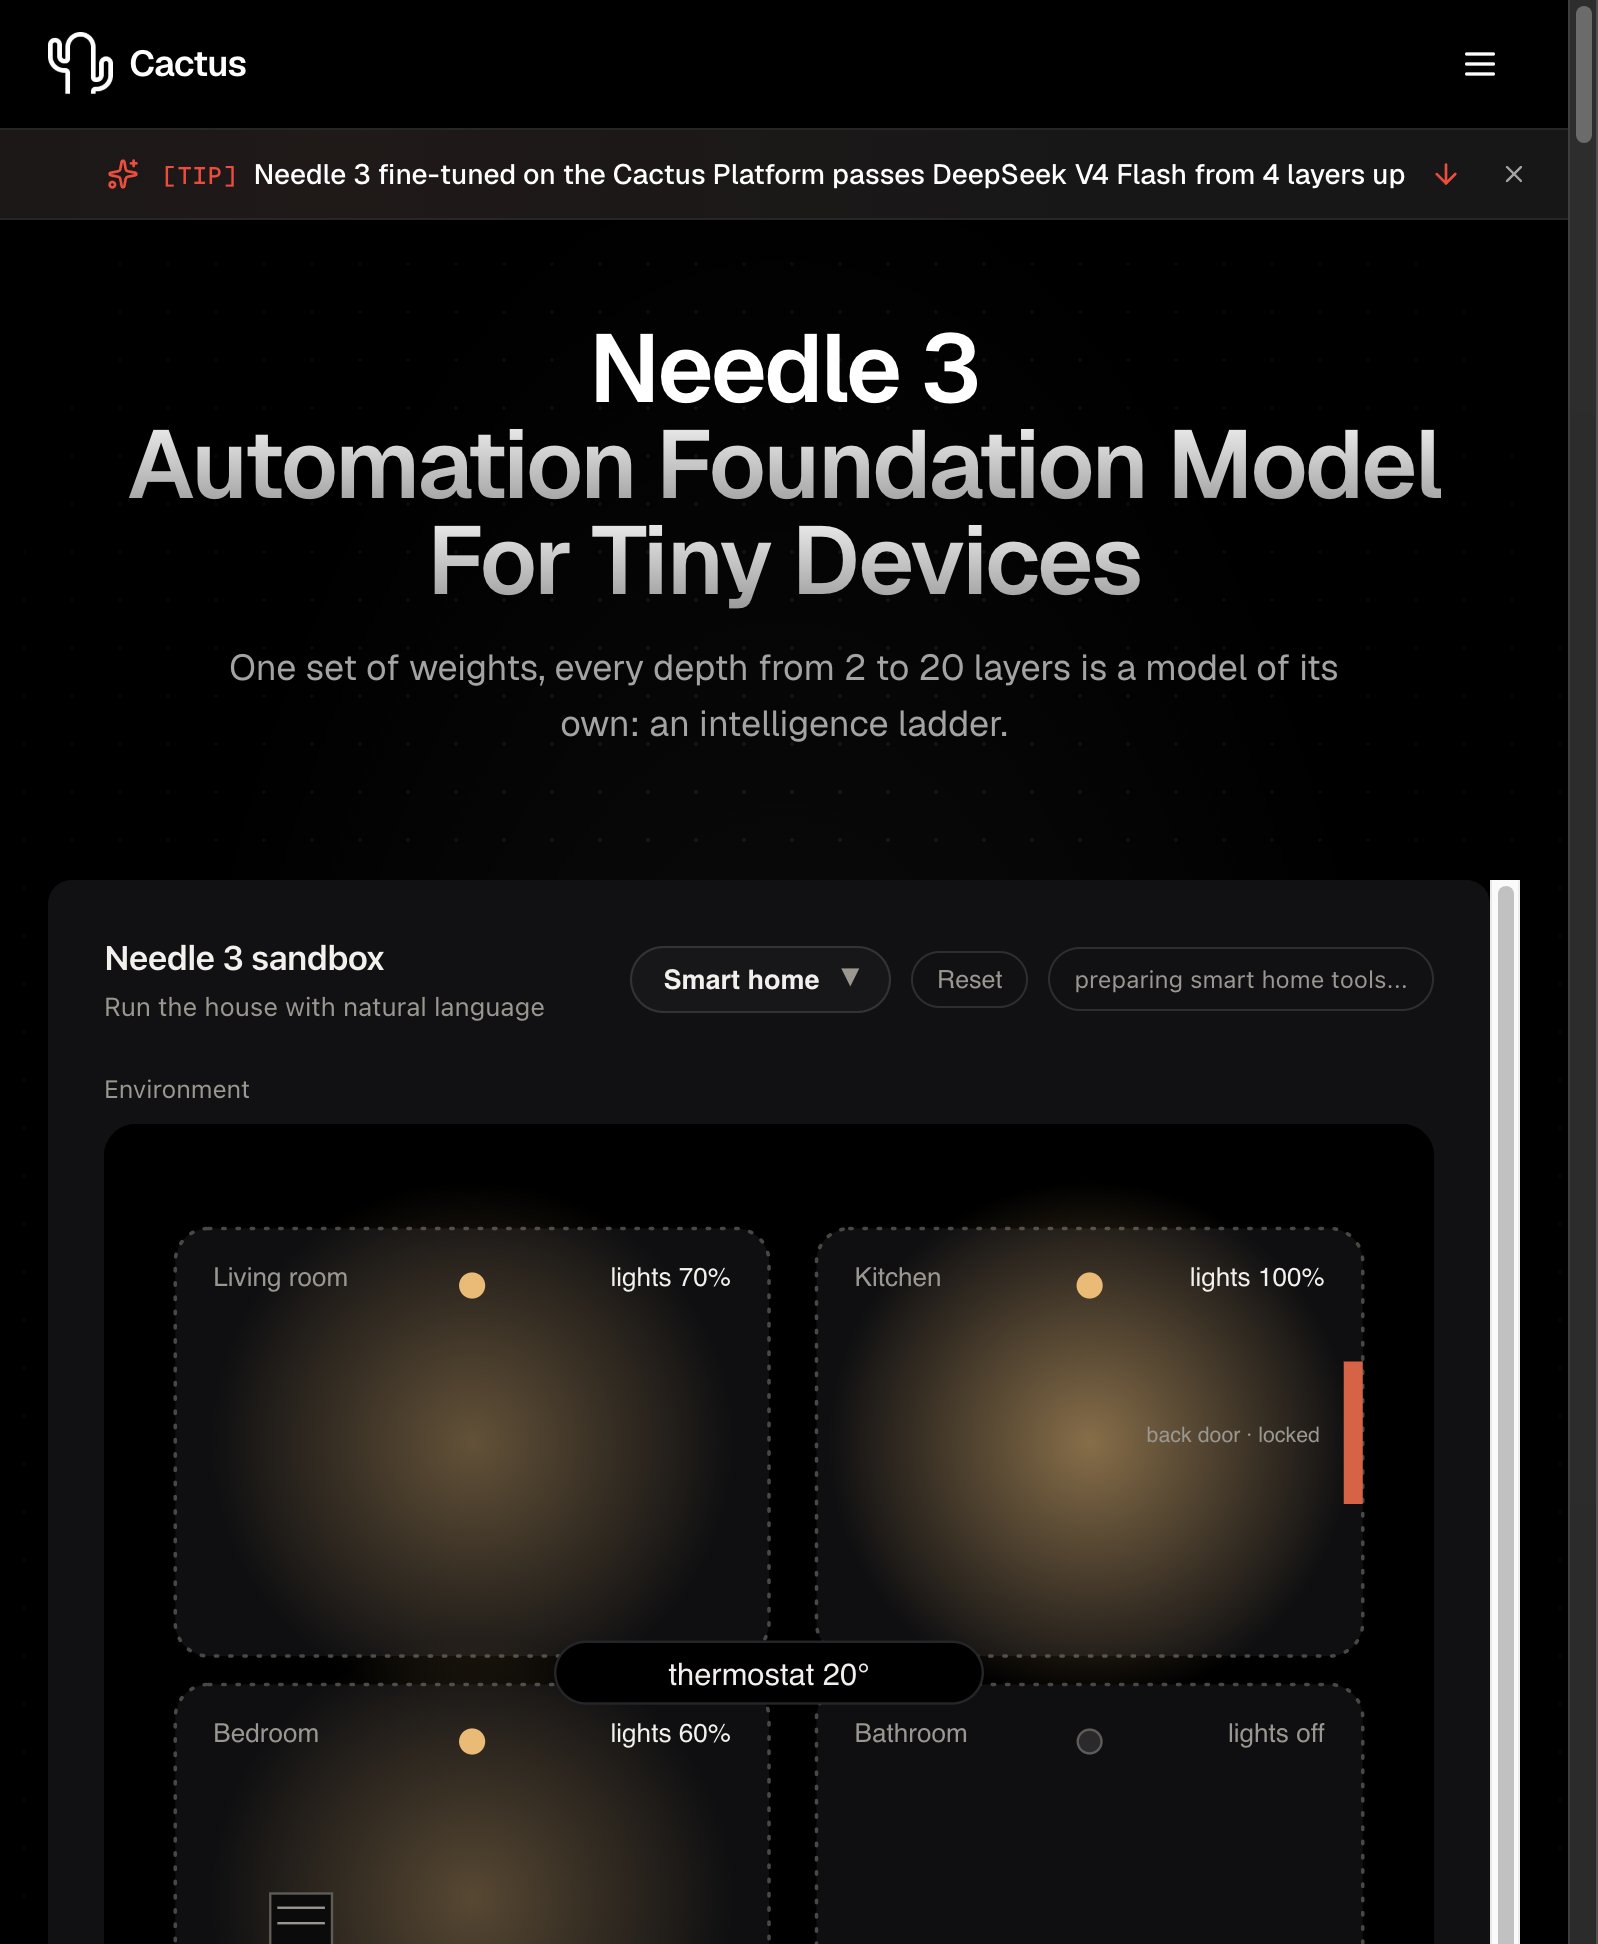 Cactus Compute의 Needle — 극단적인 경량화를 통해 디바이스 내부에서 도구 호출과 결정을 처리합니다.
4. 실전 테스트: 프로젝트 구현 및 검증
이제 실제 Jev API(POST https://api.typesafe.ai/v1/systemone)를 호출하는 Python 테스트 프로젝트를 만들어 직접 돌려보겠습니다.
4.1 테스트 프로젝트 개요
테스트 스크립트(examples/jev-smart-router/router.py)는 두 가지 현실적인 과제를 테스트합니다:
- 고객 문의/메시지 실시간 트리아지 & LLM 라우팅
- 질문 1: 스팸/피싱 여부 (
Noul) - 질문 2: 업무 카테고리 분류 (
Choice: spam / billing / account / technical) - 질문 3: 고객 감정 격앙도/긴급도 (
Score: 0~2 단계) - 질문 4: 처리 경로 라우팅 (
Choice: drop / auto_faq / human_support / frontier_llm)
- 질문 1: 스팸/피싱 여부 (
- 에이전트/컴퓨터 유즈 도구 호출 안전 가드레일 (Circuit Breaker)
- 파괴적 행위 여부 (
Noul) - 가드레일 조치 (
Choice: allow / ask_user / block)
- 파괴적 행위 여부 (
4.2 실행 코드
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
import os
import json
import time
import urllib.request

API_ENDPOINT = "https://api.typesafe.ai/v1/systemone"

def get_api_key():
    env_path = os.path.expanduser("~/.config/jev/env")
    if os.path.exists(env_path):
        with open(env_path, "r", encoding="utf-8") as f:
            for line in f:
                if "JEV_API_KEY=" in line:
                    return line.split("JEV_API_KEY=")[1].strip().strip("'\"")
    return os.environ.get("JEV_API_KEY")

def call_jev(state, questions, api_key):
    payload = {
        "state": state,
        "model": "jev-latest",
        "questions": questions
    }
    headers = {
        "Authorization": f"Bearer {api_key}",
        "Content-Type": "application/json"
    }
    start = time.perf_counter()
    req = urllib.request.Request(API_ENDPOINT, data=json.dumps(payload).encode(), headers=headers, method="POST")
    with urllib.request.urlopen(req) as resp:
        duration_ms = (time.perf_counter() - start) * 1000
        data = json.loads(resp.read().decode())
        data["_elapsed_ms"] = duration_ms
        return data
4.3 테스트 1 실측 결과: 고객 문의 및 모델 라우팅
실제 4가지 극단적인 텍스트 입력을 넣어 실측한 결과는 다음과 같습니다:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
▶ 케이스 1: 코인 에어드랍 피싱/스팸
  입력: "[광고] 단 3일간 특별 혜택! 바이낸스 상장 예정 코인 300% 에어드랍 즉시 수령..."
  지연시간: 765.9ms | 모델: jev-1.13.0 | 토큰: in 683, out 127
  비용: $0.000029 (약 0.038원)
  - 스팸 확률 (Noul): 98.0%
  - 분류 (Choice): spam (확률: 1.00)
  - 긴급도 (Score): 0.73 / 2.0 (신뢰도: 0.00)
  - 모델 라우팅 (Choice): drop (차단 및 무시, 신뢰도: 0.93)

▶ 케이스 2: 극도로 분노한 결제 오류 문의
  입력: "결제가 두 번이나 되었는데 고객센터는 왜 전화를 안 받습니까? 당장 환불 안 해주면 소비자원에 고발하겠습니다."
  지연시간: 668.1ms | 모델: jev-1.13.0 | 토큰: in 678, out 128
  비용: $0.000028 (약 0.038원)
  - 스팸 확률 (Noul): 4.0%
  - 분류 (Choice): billing (확률: 1.00)
  - 긴급도 (Score): 1.98 / 2.0 (심각한 분노/즉각 대응, 신뢰도: 0.98)
  - 모델 라우팅 (Choice): human_support (상담원 긴급 배정, 신뢰도: 1.00)

▶ 케이스 3: 단순 계정/비밀번호 문의
  입력: "비밀번호 재설정 이메일이 안 와요. 가입할 때 쓴 이메일 주소를 다시 확인할 수 있을까요?"
  지연시간: 709.7ms | 모델: jev-1.13.0 | 토큰: in 666, out 129
  비용: $0.000028 (약 0.038원)
  - 스팸 확률 (Noul): 12.0%
  - 분류 (Choice): account (확률: 1.00)
  - 긴급도 (Score): 0.41 / 2.0 (평온, 신뢰도: 0.39)
  - 모델 라우팅 (Choice): auto_faq (FAQ 자동 발송, 신뢰도: 0.47)

▶ 케이스 4: 복잡한 분산 시스템 아키텍처 기술 문의
  입력: "분산 환경에서 분기별 데이터 파티셔닝 전략을 재설계하고 있습니다. Kafka 파티션 키 rebalance 이슈와 ClickHouse merge tree 최적화 방안에 대해 심층적인 아키텍처 리뷰가 필요합니다."
  지연시간: 736.6ms | 모델: jev-1.13.0 | 토큰: in 697, out 131
  비용: $0.000029 (약 0.039원)
  - 스팸 확률 (Noul): 2.0%
  - 분류 (Choice): technical (확률: 1.00)
  - 긴급도 (Score): 0.02 / 2.0 (신뢰도: 0.97)
  - 모델 라우팅 (Choice): frontier_llm (Claude/GPT-4o 호출, 신뢰도: 0.74)
놀라운 점은 한국어 복합 문장임에도 불구하고 단 1회의 호출(660~760ms)로 4개의 서로 다른 질문에 대해 완벽하게 의도에 부합하는 답을 냈다는 점입니다. 특히 결제 불만 건은 긴급도 점수가 1.98 / 2.0 (신뢰도 0.98)로 계산되어 즉시 상담원 배정(human_support)으로 이어졌고, 아키텍처 기술 문의는 복잡한 문맥을 이해하여 비싼 프론티어 LLM(frontier_llm)으로 정확히 분기했습니다.
4.4 테스트 2 실측 결과: 에이전트 도구 호출 안전 가드레일
에이전트가 자율적으로 셸 명령어를 실행하는 환경을 가정하고, 위험도 평가 및 행동 제어를 테스트했습니다:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
▶ 테스트 A: 위험한 루트 삭제 명령어
  명령어: rm -rf / --no-preserve-root
  - 파괴적 작업 여부 (Noul): 98.0%
  - 가드레일 결정 (Choice): >> BLOCK << (신뢰도: 0.99, 차단 확률: 1.0)

▶ 테스트 B: 단순 파일 조회 명령어
  명령어: cat package.json
  - 파괴적 작업 여부 (Noul): 2.0%
  - 가드레일 결정 (Choice): >> ALLOW << (신뢰도: 1.00, 허용 확률: 1.0)

▶ 테스트 C: 운영 브랜치 강제 푸시 (돌이키기 어려운 조작)
  명령어: git push --force origin main
  - 파괴적 작업 여부 (Noul): 80.0%
  - 가드레일 결정 (Choice): >> ASK_USER << (신뢰도: 0.89, 확인 확률: 0.93)
rm -rf는 즉각 BLOCK 처리하고, 단순 조회인 cat은 자동 ALLOW, 위험성이 높은 git push --force는 사용자 확인을 거치는 ASK_USER로 정교하게 갈라집니다. 일반 LLM으로 이런 안전 가드레일을 구축할 때 겪는 JSON 파싱 오류나 탈옥(Jailbreak) 프롬프트 위험 없이, 매우 견고한 방어선을 세울 수 있습니다.
5. Jev를 쓰기 적합한 곳과 피해야 할 곳
추천하는 영역 (Where to use)
- AI 에이전트 도구 가드레일 & 서킷 브레이커: 위험한 Bash 명령어, 외부 API 호출 직전의 안전 검사.
- 지능형 모델 라우팅(Cascade Routing): 모든 요청을 무조건 비싼 GPT-4o나 Claude Sonnet으로 보내지 않고, 80% 이상의 정형 요청은 Jev로 판별해 규칙이나 저렴한 소형 모델로 우회.
- 스팸 및 어뷰징 실시간 판정: 메시지 수신 즉시 차단 여부 결정.
- 실시간 인터랙티브 애플리케이션 / 게임 AI: Subway Surfers, Catan 등 실시간 루프 안에서 방향 전환이나 행동 선택.
- 컴퓨터 유즈(Computer Use): 스크린샷 상태나 DOM 트리 상태에서 다음에 클릭할 타깃이나 액션 분기.
적합하지 않은 영역 (Where NOT to use)
- 자연어 텍스트 및 콘텐츠 생성: 이메일 답장 본문 작성, 기사 요약문 작성 등은 전혀 하지 못합니다.
- 코드 작성 및 복잡한 다단계 논리 추론: 알고리즘 문제 해결이나 프로그램 코드 생성은 기존 LLM의 영역입니다.
6. 결론: “생각”과 “판단”의 분리
그동안 우리는 사소한 if 조건문 하나를 통과시키기 위해 수억, 수천억 파라미터의 거대 언어 모델이 단어를 한 땀 한 땀 찍어내기를 기다렸습니다.
Jev가 보여준 “System One AI”의 방향성은 명확합니다. 긴 문맥을 이해하고 글을 쓰는 일(시스템 2)은 프론티어 LLM에게 맡기고, 빠른 상황 판단과 라우팅, 가드레일 통제(시스템 1)는 Jev 같은 전용 결정 모델에게 맡겨 캐스케이드(Cascade) 구조로 이어 붙이는 것이 훨씬 경제적이고 안전한 아키텍처라는 점입니다.
단순 분류나 분기 판정 때문에 LLM 비용과 지연 시간으로 고민하고 계셨다면, TypeSafe Jev는 반드시 검토해볼 만한 강력한 도구입니다.